主题
使用工具操作数据库与使用 Node 操作数据库 - Mong(Day12 2/3)
本页对应 Day12_Node&MongoDB,共 7 段视频,约 1 小时 49 分。
学习目标
- 能够使用 MongoDB 命令行完成数据库的查看、切换/创建与删除,并解释空数据库不出现在
show dbs中的原因。 - 能够使用命令行完成集合的创建、查看、重命名与删除,并正确使用当前数据库对象
db操作集合。 - 能够使用
insert、find、findOne、update、remove等命令完成文档增删改查,区分整体替换与$set局部更新、单条更新与批量更新。 - 能够编写包含比较运算符、逻辑运算符、正则表达式以及
limit、skip、count的查询条件,并验证查询结果。 - 能够使用 MongoDB Compass 连接本地 MongoDB 服务,完成数据库、集合和文档的可视化增删改查。
- 能够按“导入 mongoose、连接数据库、监听连接事件、定义 Schema、创建 Model、通过 Model 操作数据”的步骤编写 Node.js 程序,并验证插入结果与 Schema 类型校验效果。
知识点
命令行操作数据库:先会“看”和“切”
为什么需要:后端开发绕不开数据库,命令行能让我们看清 MongoDB 的最小操作流程。
怎么想:先连接服务,再看库、切库;空库不会出现在 show dbs 里。
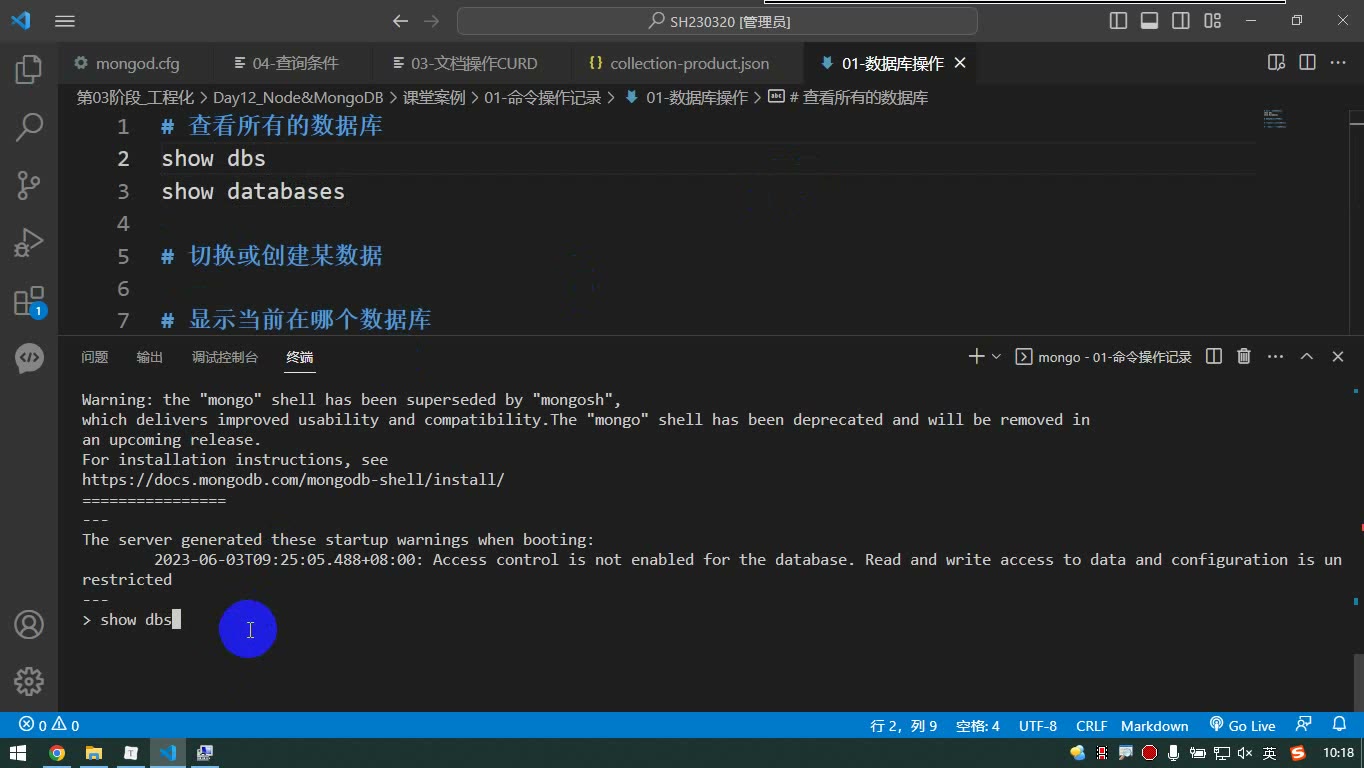
怎么做:终端输入 mongo 进入;show dbs 看数据库;use project01 切换或创建;db 看当前库;删除当前库先 use 再 db.dropDatabase()。退出可用 exit 或 Ctrl+C。
易错点:admin、local、config 不要乱删;新建空库后 show dbs 看不到,是因为库中没有集合。
bash
mongo
show dbs
use project01
db
db.dropDatabase()集合操作:库里的“表”要先建出来
为什么需要:文档不能直接挂在库上,必须先有集合。
怎么想:集合类似表,但 MongoDB 不强制文档结构完全一致;开发时仍应保持规范。
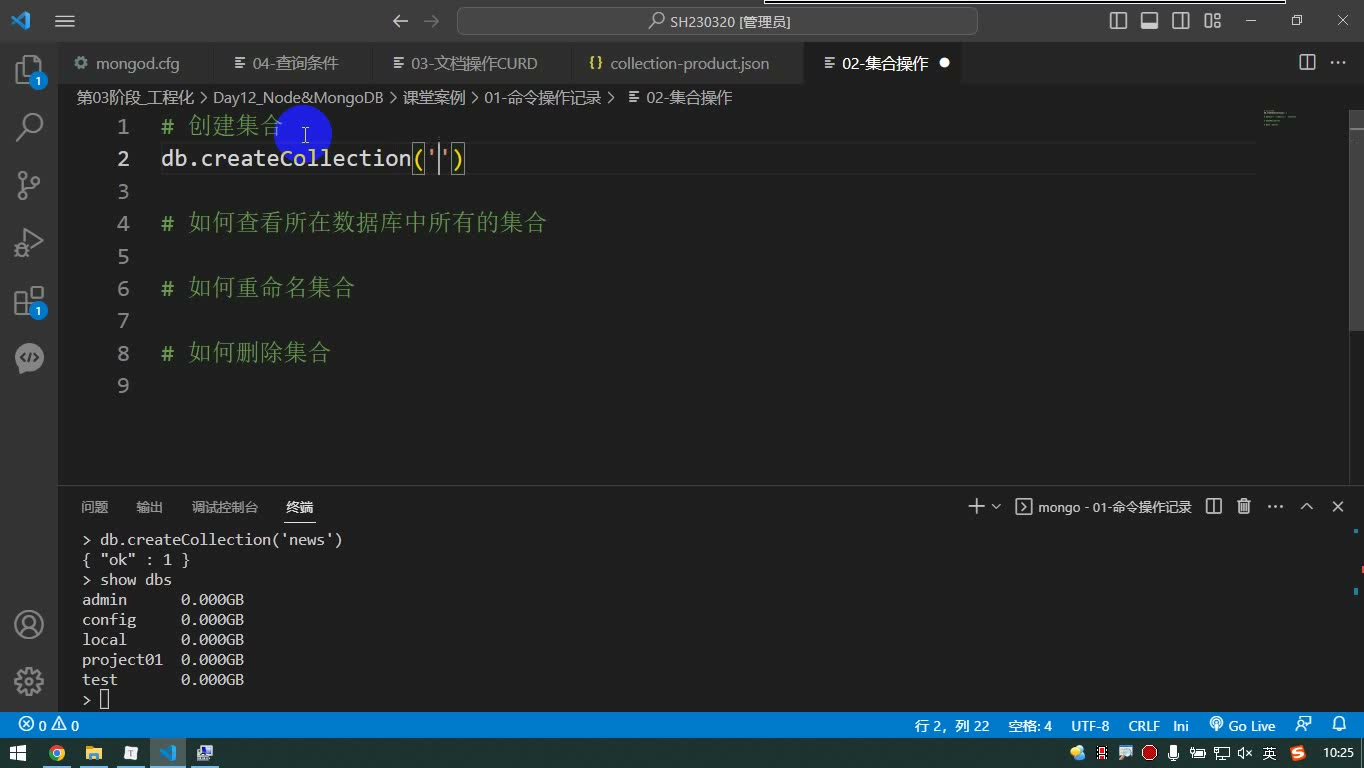
怎么做:db.createCollection('users') 创建;show collections 查看;db.users.renameCollection('articles') 重命名;db.articles.drop() 删除。
易错点:创建、重命名、删除都针对“当前数据库”;空库不显示,建完集合后再 show dbs 才能看到。
文档增删改查:重点在查询条件和 $set
为什么需要:真正存数据的是文档,增删改查是后端最常做的事。
怎么想:插入就是写对象;查询条件也是对象;更新要区分“替换整个文档”和“只改某个属性”。
怎么做:
bash
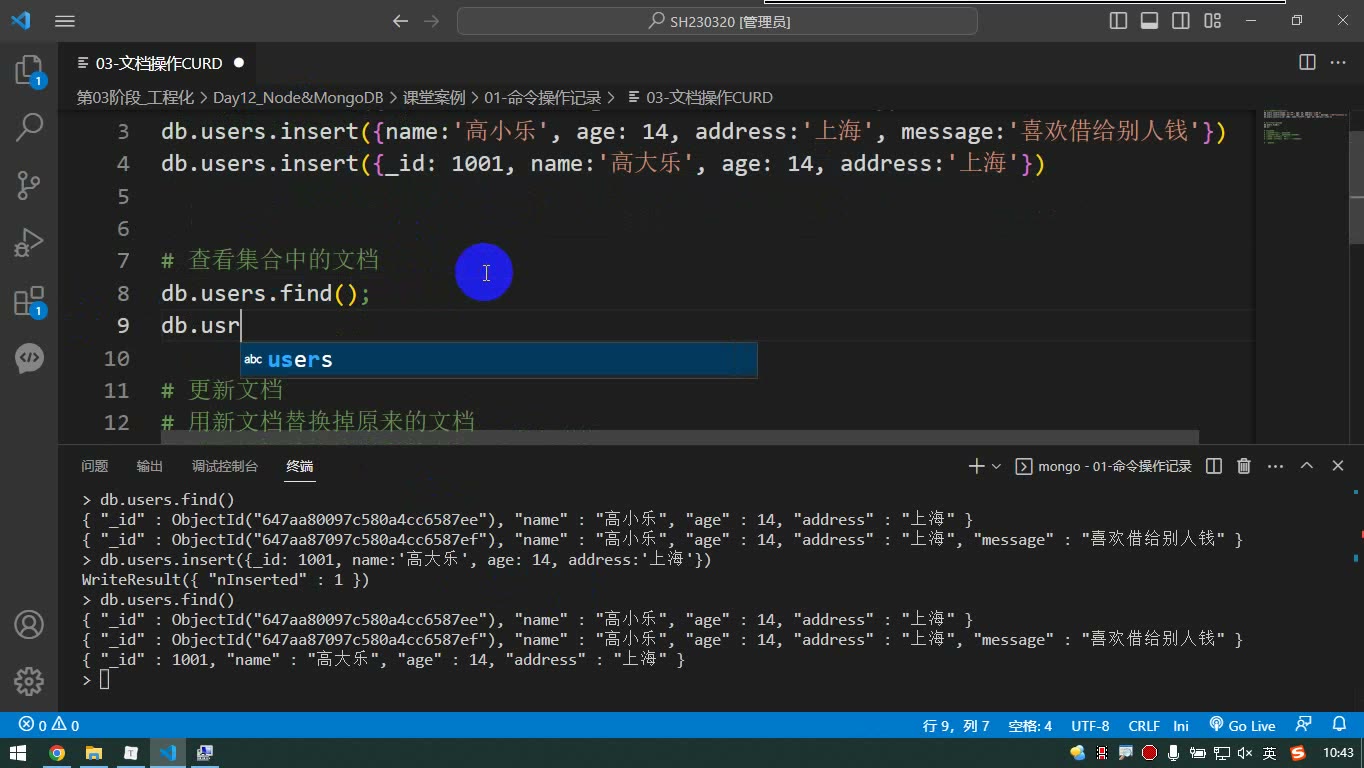
db.users.insertOne({name:'高晓乐', age:18, address:'上海'})
db.users.find()
db.users.findOne()
db.users.updateOne({name:'高晓乐'}, {$set:{address:'北京'}})
db.users.deleteOne({name:'高晓乐'})
db.songs.find({author:'谭维维'})
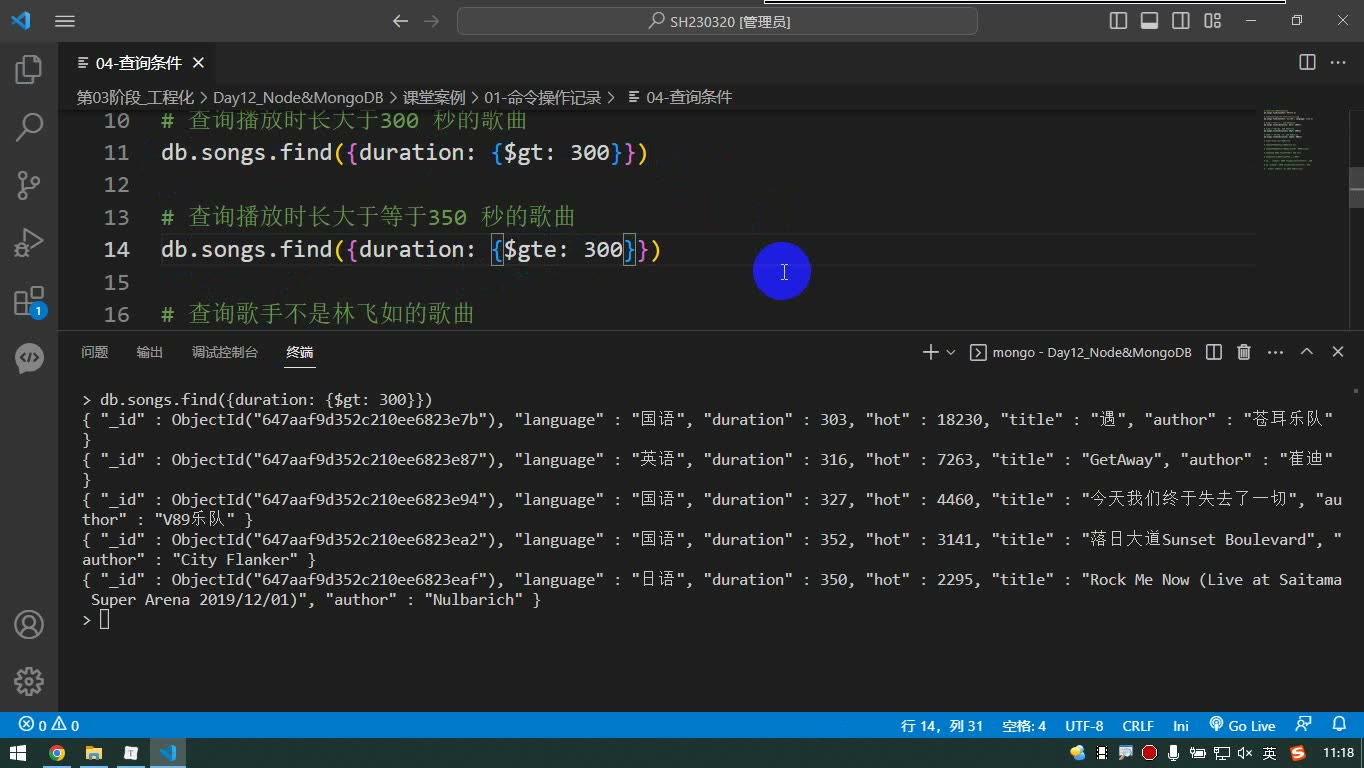
db.songs.find({duration:{$lt:150}})
db.songs.find({author:{$in:['蔡徐坤','林飞如']}})
db.songs.find({$or:[{duration:{$lte:100}},{duration:{$gte:300}}]})
db.songs.find().skip(15).limit(3)易错点:updateOne 不加 $set 会用新文档替换旧文档,原属性可能丢失;updateMany 才批量改;$lt/$lte/$gt/$gte/$ne/$in/$or 是查询操作符;删除最好带条件,避免误删。调试时若查不到,先 db 看当前库,再 show collections 看集合名。
图形化客户端:Compass 降低操作门槛
为什么需要:命令行适合走流程,图形化工具更适合日常查看和简单管理。
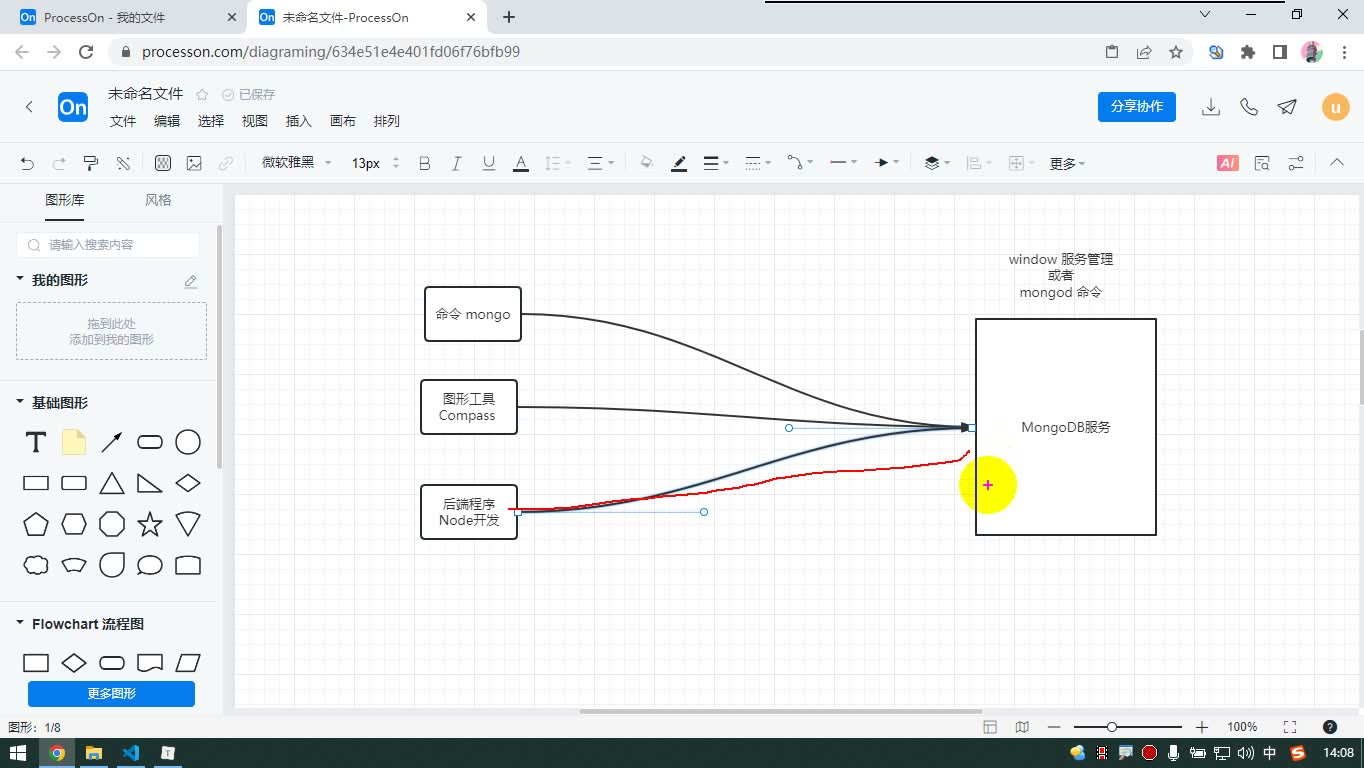
怎么想:Compass 与 mongo 命令同级,都是连接 MongoDB 服务后发指令。
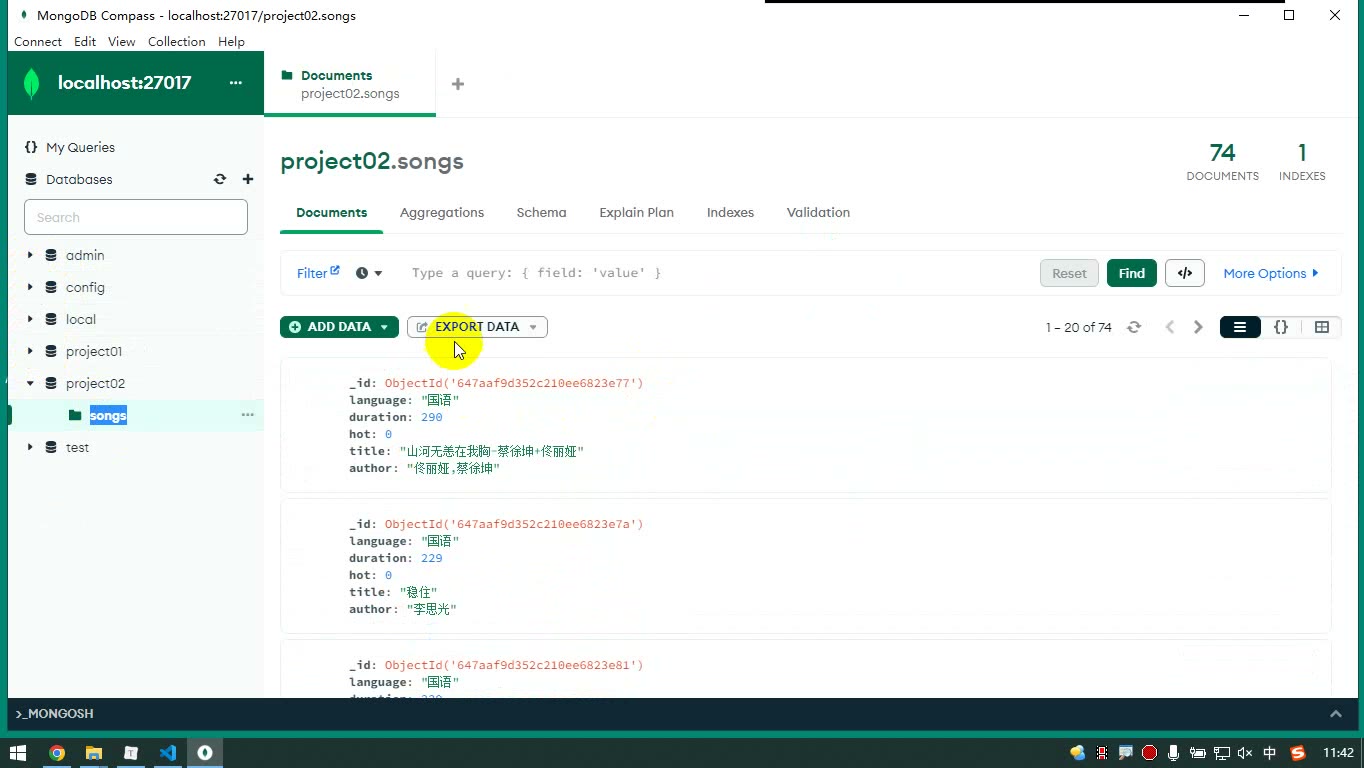
怎么做:打开 Compass,默认连接 localhost:27017;展开数据库和集合,可用表格或 JSON 查看文档,也能创建/删除库、集合,插入、修改、删除文档。
易错点:它连的是同一个服务,改动会立即反映到命令行;删除库/集合常要求再次输入名称,防止误删。
mongoose:用程序操作数据库的标准步骤
为什么需要:后端程序不能靠手敲命令,需要用 Node.js 连接 MongoDB 并发送指令。
怎么想:mongoose 是第三方模块,负责建立连接、定义文档结构、创建模型;模型映射集合。
怎么做:安装 npm i mongoose@6,按“导入模块 → 连接服务 → 监听成功/失败 → 定义 Schema → 创建 Model → 用 Model 增删改查”走。
js
const mongoose = require('mongoose');
mongoose.connect('mongodb://127.0.0.1:27017/project04');

mongoose.connection.on('open', () => console.log('数据库连接成功'));
mongoose.connection.on('error', err => {
  console.log('数据库连接失败');
  throw err;
});

const usersSchema = new mongoose.Schema({
  name: String,
  age: Number,
  address: String,
  ctime: Date
});
const UserModel = mongoose.model('users', usersSchema);

UserModel.create({
  name: '高晓乐',
  age: 18,
  address: '上海',
  ctime: new Date()
}, (err, doc) => {
  if (err) return console.log('添加文档失败');
  console.log('添加文档成功', doc);
});易错点:Schema 规定属性类型,age 写数组会失败,写纯数字字符串可能被转换;后续操作应等连接成功后再执行;命令行里练过的 find/update/delete 思路,会迁移到 Model 上。
本节定位:Node 程序也是 MongoDB 的客户端
先建立一个整体图景。转写稿里反复用到一个类比:mongo 命令行工具、Compass 这类图形化客户端,以及我们写的 Node 后端程序,处在同一个生态位上——它们都要先连接 MongoDB 服务,再向服务发送指令,最后接收服务返回的数据。命令行里敲 show dbs、use project02、db.sounds.find(),图形化工具里点鼠标,本质上都是在做这件事;Node 程序只是把“人敲命令”换成了“代码调用 API”。
为什么需要这个认识? 因为初学者容易把“安装驱动”误解成“安装数据库”。MongoDB 服务是服务端,Node 里的驱动只是客户端侧的一个中间模块。怎么想? 先分清三层:MongoDB 服务、客户端工具/程序、连接通道。Node 不能凭空操作数据库,必须通过驱动建立连接并发送指令。怎么做? 学习本节时,先把驱动当成“Node 与 MongoDB 服务之间的翻译层”,不要把它和数据库本体混在一起。易错点:把 npm install mongodb 当成安装 MongoDB;或者以为装了驱动,数据库服务就自动启动了。转写稿中 mongo 命令连接的是已经启动的服务,这个前提同样适用于 Node 程序。
为什么需要 MongoDB Native Driver
MongoDB 官方提供了 Node 驱动,也就是本节笔记说的 MongoDB Native Driver。它运行在 Node 中,JavaScript 可以调用该驱动提供的 API,实现对 MongoDB 的操作。换句话说,如果没有驱动,Node 程序就没法用 JavaScript 的方式跟 MongoDB 服务通信;有了官方驱动,我们才可以在 Node 项目里发起数据库操作。
为什么需要它? 因为后端程序不能只靠命令行或图形化工具管理数据,实际业务要通过代码读写数据库。怎么想? 官方驱动是最直接的一层:它由 MongoDB 官方提供,定位清晰,适合理解“Node 如何连数据库”的底层流程。怎么做? 使用前先安装:
bash
npm install mongodb安装的是 Node 项目依赖,不是数据库服务。易错点:把包名记成数据库名;在错误目录下安装;安装后不检查 package.json 和 node_modules 是否生成。转写稿里讲 Mongoose 安装时也强调“这玩意儿可不是装数据库,装的是模块”,这个提醒同样适用于 mongodb 驱动。
怎么想:先连接,再操作,最后处理异步结果
虽然本节笔记没有展开 Native Driver 的具体 API,但转写稿给了很重要的推导:后端程序要和 MongoDB 服务建立连接,连接不是瞬间完成的,发送指令、接收返回数据也需要时间,所以 Node 里大量操作是异步的。视频 7 讲 Mongoose 时用“连接成功事件 / 连接失败事件”和回调函数处理结果,这个思路可以帮助理解 Native Driver 的调试过程:先确认连接是否成功,再执行后续操作;失败时要能看到错误对象,而不是只看到“没反应”。
为什么需要这样想? 因为数据库操作不是本地变量赋值,网络连接、服务状态、权限、端口都会影响结果。怎么做? 调试时按顺序排查:MongoDB 服务是否启动;连接地址和端口是否正确,默认端口是 27017;代码是否在连接成功后才发起操作;错误是否被回调或异常处理接住。易错点:连接还没成功就执行查询;把失败回调里的错误吞掉;看到警告就以为一定失败。转写稿中 Mongoose 连接成功后打印“数据库连接成功”,失败时抛出错误对象,这就是可借鉴的调试习惯。注意不要编造 Native Driver 的具体方法名,实际写法以官方文档为准。
与 Mongoose 的关系:本节是“认识官方驱动”,不是终点
本节笔记最后有一句很关键的注意:目前更多使用的是 Mongoose! 转写稿也明确说,MongoDB Native Driver 是官方提供的,但“用着很费劲”,后面主要用 Mongoose 这个第三方模块。Mongoose 在驱动之上做了封装,提供 Schema、Model 等概念:Schema 规定集合中文档有哪些属性、属性是什么类型;Model 与集合对应,后续增删改查通过模型完成。视频 7 的六步流程——导入模块、连接、监听成功/失败、创建 Schema、创建 Model、通过 Model 操作数据——说明 Mongoose 让代码更规范。
为什么需要知道这个? 因为学习 Native Driver 不是为了背一堆 API,而是理解 Node 操作数据库的基本层次;知道它和 Mongoose 的关系,才不会把两者混为一谈。怎么想? Native Driver 更接近官方底层能力;Mongoose 更像带规范约束的开发框架。怎么做? 本节先把官方驱动的定位和安装掌握好,后续再用 Mongoose 做项目。易错点:把 mongodb 和 mongoose 当成同一个包;以为学了 Native Driver 就不需要 Mongoose;或者反过来,以为 Mongoose 不需要底层 MongoDB 服务。转写稿里命令行操作、图形化工具、Node 程序最终都连同一个服务,这一点始终不变。
易错点汇总:从命令行调试反推代码习惯
转写稿里的命令行演示虽然不等于 Native Driver API,但暴露了很多数据库操作的通病,可以迁移到 Node 代码里。第一,空数据库执行 show dbs 不显示,创建了数据库但里面没有集合时也看不到;写代码时不要因为“查不到库”就以为连接失败。第二,use 一个不存在的数据库会切换并创建,但真正有集合后才更容易被列出;Node 里也不要假设“建库”和“建集合”是同一个动作。第三,更新文档时如果直接拿新对象替换旧文档,容易把其他属性冲掉;应使用 $set 这类操作符只改指定字段。第四,删除不加条件很危险,命令行会要求查询条件,代码里也要先写条件再删。第五,_id 会自动生成,不要随意手写覆盖。
这些调试经验说明:Node 操作数据库不能只记“能跑”,还要知道数据处于什么状态、条件是否精确、失败是否被捕获。把本节 Native Driver 的定位、安装和异步连接思维打牢,再进入 Mongoose,就不会在“驱动、框架、数据库服务”三者之间反复混淆。
从命令行到 Node:先分清生态位
为什么需要:初学数据库时容易把 MongoDB 服务、命令行、图形化工具、Node 程序混在一起。转写稿反复强调:mongod 服务相当于 Windows 服务管理;mongo 命令行和 Compass 图形化工具是“客户端”,都向服务发指令;Node 后端程序也处在同一生态位,只是用代码发指令。
怎么想:先会用命令行走一遍 CRUD,再换 Mongoose,方法名会很相似,理解成本低。
怎么做:命令行里先 mongo 连接;show dbs 看数据库;use project01 切换或创建;db 看当前库;db.createCollection('users') 建集合;show collections 查看;db.users.insert({...}) 插文档;db.users.find() 查文档。
易错点:show dbs 不显示空数据库;删除数据库要先 use 进入目标库,再 db.dropDatabase();不要动 admin、config、local 等默认库。
命令行 CRUD 与查询条件
为什么需要:Mongoose 的查询条件、更新操作符和命令行几乎一一对应,先理解 $lt、$set 等符号,后面写代码才不懵。
怎么想:把“条件”写成对象;比较用 $lt/$gt/$gte/$lte/$ne;或条件用 $in/$or;更新只改字段要用 $set。
怎么做:
bash
db.songs.find({ author: '谭维维' })
db.songs.find({ language: '国语', author: '林飞如' })
db.songs.find({ duration: { $lt: 150 } })
db.songs.find({ author: { $ne: '林飞如' } })
db.songs.find({ author: { $in: ['蔡徐坤', '林飞如'] } })
db.songs.find({ $or: [{ author: '蔡徐坤' }, { author: '林飞如' }] })
db.songs.find().limit(10).skip(15)更新时:db.users.update({ name: '高晓乐' }, { $set: { address: '乌鲁木齐' } });批量用 updateMany。删除:db.users.remove({ name: '高晓乐' })。
易错点:直接 update(条件, 新文档) 会用新文档替换旧文档,其他字段丢失;$set 少写大括号会语法错误;_id 是 ObjectId 对象,不是字符串,拿字符串查/改会匹配不到;remove 不写条件会被阻止,别误删全表。
图形化工具:Compass 与 Studio 3T
为什么需要:命令行适合理解流程,图形化工具适合日常查看和简单管理。
怎么想:它们和 mongo 命令等价,都是先连接 localhost:27017,再操作库、集合、文档。
怎么做:Compass 新建连接,默认地址 localhost:27017,连接后可展开数据库、集合,用表格看文档,也能插入、修改、删除,还能直接写 db.songs.find()。Studio 3T 类似,选择非商业用途可学习使用。
易错点:图形化工具是应用级工具,不是服务;服务没启动时连不上。删除集合/数据库常要求再输入名称确认,防止手滑。
为什么用 Mongoose:连接与六步流程
为什么需要:Node 不能直接手写底层 socket 去连 MongoDB,需要中间模块。官方 mongodb 驱动较底层,Mongoose 是第三方 ODM,对 JS 更友好。转写稿建议本节用 mongoose@6,因为 7 默认转向 Promise 写法,容易和当前回调写法混。
怎么想:先导入模块,再连接服务,监听成功/失败,然后定义 Schema、创建 Model,最后用 Model 做 CRUD。
怎么做:
bash
npm init -y
npm i mongoose@6js
const mongoose = require('mongoose');

mongoose.connect('mongodb://127.0.0.1:27017/project04');

mongoose.connection.once('open', () => {
  console.log('数据库连接成功');
});

mongoose.connection.on('error', (err) => {
  console.log('数据库连接失败');
  throw err;
});易错点:连接字符串要带数据库名;库不存在时,写入数据后会自动创建;若出现 strictQuery 警告,是 6 与 7 的默认值差异,不影响本节开发,可按提示设置,不必纠结。
Schema 与 Model:规定文档结构
为什么需要:MongoDB 本身不强制同一集合文档结构一致,但真实开发应统一。Mongoose 用 Schema 规定字段和类型,用 Model 映射集合。
怎么想:Schema 描述“集合里的文档长什么样”;Model 是根据 Schema 创建的、对应集合的对象,后续 CRUD 都通过 Model。
怎么做:
js
const usersSchema = new mongoose.Schema({
  name: String,
  age: Number,
  address: String,
  ctime: Date
});

const userModel = mongoose.model('users', usersSchema);易错点:Schema 不是集合本身;Model 才是操作入口。类型写 Number 时,字符串数字可能被转换,数组或 hello 这类无法转成有效数字的值会失败。
用 Model 新增文档与调试
为什么需要:验证连接、Schema、Model 是否打通,最直接就是插入一条文档。
怎么想:create 第一个参数是文档对象,第二个是回调;回调参数是 err 和返回数据。
怎么做:
js
userModel.create({
  name: '高晓乐',
  age: 18,
  address: '上海',
  ctime: new Date()
}, (err, data) => {
  if (err) {
    console.log('添加文档失败');
    return;
  }
  console.log('添加文档成功', data);
});运行 node 01.js,看到“数据库连接成功”和“添加文档成功”,数据里会自动出现 _id 和版本号。转写稿还演示了:age 传数组会失败;传字符串数字可转;传 hello 会转成 NaN 而失败。
易错点:回调里先判断 err;不要自己乱写 _id,默认 ObjectId 更可靠;后续查询、修改、删除也统一走 userModel,不要一会儿命令行一会儿模型混着写。
课堂画面
代码示例
示例一:mongosh 命令行 —— 数据库 / 集合 / 文档的增删改查
javascript
// 在终端执行 mongosh 进入数据库操作界面后,逐条粘贴运行
// ========== 一、数据库操作 ==========
show dbs                      // 查看所有数据库(空库不显示)
use project01                 // 切换数据库;不存在则自动创建
db                            // 查看当前所在数据库
db.dropDatabase()             // 删除“当前所在”数据库

// ========== 二、集合操作 ==========
use project01
db.createCollection('users')           // 创建集合
db.createCollection('news')
show collections                       // 查看当前库的所有集合
db.news.renameCollection('articles')   // 重命名集合
db.articles.drop()                     // 删除集合

// ========== 三、文档操作 ==========
use project01
db.users.insert({ name: '高晓乐', age: 18, address: '上海' })
db.users.insert({ name: '高晓乐', age: 20, address: '上海', message: '喜欢借给别人钱' })
db.users.find()                        // 查看集合中全部文档
db.users.findOne()                     // 只看满足条件的第一条

// 更新写法一:整体替换(危险,会把原文档其它属性全冲掉,且只改第一个)
db.users.update({ name: '高晓乐' }, { address: '北京' })

// 更新写法二:$set 只改指定属性(推荐,其余属性保留,新属性会追加)
db.users.update(
  { _id: ObjectId('把这里的值换成真实的下划线ID') },
  { $set: { address: '乌鲁木齐' } }
)

// 批量更新:热度 5000 以上的歌曲时长全部改成 100
db.sounds.updateMany({ hot: { $gte: 5000 } }, { $set: { duration: 100 } })

// 删除文档:必须带查询条件
db.users.remove({ name: '高晓乐' })要点解释 / 易错点
use project01只是切到一个“不存在”的库,show dbs里看不到它 —— 库里没有集合就不显示,创建集合后才会出现。db.dropDatabase()删的是当前所在的库,所以删之前必须先use进去。insert直接传对象即可,MongoDB 会自动补一个唯一的_id;自己写_id也可以,但就没有默认的唯一标识了,不建议。- 两个文档结构不一致也能插进去(MongoDB 不强制),但实际开发要统一,否则后面查询很乱。
update(条件, 新文档)这种两参数写法是用新文档整体替换旧文档,name、age都会丢,而且只改匹配到的第一个,非常危险。$set是属性名,它的值才是对象,即{ $set: { address: '...' } };少写一层大括号就是语法错误。_id不是字符串而是ObjectId对象,必须写ObjectId('...'),直接写字符串不会报错但一条也匹配不到(不会更新)。remove()不写条件会被拒绝执行,要全删就用remove({})。
示例二:mongosh 命令行 —— 查询条件
javascript
// 前提:project02 库的 songs 集合中已有 100 条歌曲文档
// 文档结构:{ _id, language, duration, hot, title, author }
use project02

db.sounds.find({ author: '谭维维' })                      // 等值匹配
db.sounds.find({ author: '林飞如', language: '国语' })     // 多个条件 = “并且”
db.sounds.find({ duration: { $lt: 150 } })                // 小于
db.sounds.find({ duration: { $gt: 300 } })                // 大于
db.sounds.find({ duration: { $gte: 350 } })               // 大于等于
db.sounds.find({ duration: { $lte: 350 } })               // 小于等于
db.sounds.find({ author: { $ne: '林飞如' } })              // 不等于

db.sounds.find({ author: { $in: ['蔡徐坤', '林飞如'] } })  // 或者(写法一)
db.sounds.find({ $or: [{ author: '蔡徐坤' }, { author: '林飞如' }] }) // 或者(写法二)

db.sounds.find({ hot: { $gte: 5000 }, duration: { $gte: 200 } }) // 多条件并且
db.sounds.find({ author: /蔡徐坤/ })                       // 正则:包含即可
db.sounds.find().count()                                   // 统计数量
db.sounds.find().limit(10)                                 // 只看前 10 条
db.sounds.find().skip(15).limit(3)                         // 从第 15 条起取 3 条

db.sounds.findOne({ hot: { $gt: 5000 } })                  // 满足条件的第一条

// 删除:时长 100 及以下 或者 300 及以上
db.sounds.remove({
  $or: [
    { duration: { $lte: 100 } },
    { duration: { $gte: 300 } }
  ]
})要点解释 / 易错点
- 查询条件就是一个对象:键是文档里的属性名,值是字符串时是精确匹配。
- 比较运算必须写成
{ $lt: 150 }这种对象形式,不能写duration < 150;$gt / $gte / $lt / $lte / $ne对应> >= < <= !=。 - 多个条件写进同一个对象就是“并且”;“或者”要用
$in(值是数组)或$or(值是对象数组)。 - 正则
/蔡徐坤/是“包含”,普通字符串是“完全相等”,两者结果差别很大。 limit与skip同时用时,skip 写在前面:.skip(15).limit(3)。find()返回的是游标,count()要加括号调用;findOne()不加条件就等于取第一条。remove里用$or时注意数组里放的是两个完整条件对象,括号层级错一个就报语法错误。
示例三:Node + Mongoose 六步走通“连接 → Schema → Model → 新增”
javascript
// 01.js —— 先在项目目录执行:npm init -y && npm i mongoose@6
const mongoose = require('mongoose');

// 第 2 步:连接 MongoDB 服务(27017 是默认端口,末尾是数据库名)
mongoose.connect('mongodb://127.0.0.1:27017/project04');

// 第 3 步:监听连接成功 / 失败事件
mongoose.connection.on('open', () => {
  console.log('数据库连接成功');
});
mongoose.connection.on('error', (err) => {
  console.log('数据库连接失败');
  throw err;
});

// 第 4 步:创建文档结构 Schema —— 规定集合中文档有哪些属性、什么类型
const usersSchema = new mongoose.Schema({
  name: String,
  age: Number,
  address: String,
  ctime: Date
});

// 第 5 步:根据 Schema 创建与集合对应的模型(参数1:集合名,参数2:Schema)
const UserModel = mongoose.model('users', usersSchema);

// 第 6 步:通过模型操作数据 —— 添加文档
UserModel.create({
  name: '高晓乐',
  age: 18,
  address: '上海',
  ctime: new Date()
}, (err, rs) => {
  if (err) {
    console.log('添加文档失败');
    return;
  }
  console.log('添加文档成功,添加的数据是:', rs);
});要点解释 / 易错点
- 连接串固定格式
mongodb://127.0.0.1:27017/数据库名;库和集合都不存在也没关系,插入数据时会自动创建。 - 连接是异步的,所以连接结果要靠
connection.on('open')/on('error')两个事件来监听,后续增删改查要等连接成功后再做。 Schema对标的是集合里的文档结构,不是数据库:一个集合配一个 Schema,规定属性和类型。model()的第一个参数是集合名,必须和数据库里的集合名一致,写错就会操作到另一个集合上。create()的第二个参数是回调,两个参数是(err, rs),必须先判err;rs就是刚插入的那条文档,里面带着自动生成的_id。- 类型不对时 Mongoose 会先尝试转换:
age: '89'能转成数字可以插入;age: [1,2]或age: 'hello'转不动,就走err分支。 - 本节用
mongoose@6才有这种回调写法,7已全面改成 Promise 写法,别装错版本。
常见错误
1. use project01 之后 show dbs 找不到这个库
- 现象:明明切过去并
db确认了,show dbs列表里就是没有。 - 原因:库里一个集合都没有时,属于空库,MongoDB 不把它列出来。库本身已经"存在"于当前会话,只是没落盘展示。
- 修法:先
db.createCollection('users')建一个集合,再show dbs;或者干脆先插一条文档。判断"有没有建成功"用show collections,不要用show dbs。
2. 更新完一条文档,发现别的字段全没了
- 现象:只想改
address,执行完db.users.update({name:'高晓乐'},{address:'北京'})后,age、name都不见了。 - 原因:
update第二个参数给普通对象时,语义是"用这个新文档整体替换旧文档",不是"改其中某个字段"。 - 修法:改局部字段必须用
$set:db.users.update({_id:...},{$set:{address:'北京'}})。要改多条加{multi:true}(或updateMany),否则默认只改匹配到的第一条。
3. 拿着复制来的 _id 字符串去更新/查询,一条都匹配不到
- 现象:条件里写
_id: '64f...',命令不报错,但matchedCount是 0。 - 原因:
_id的类型是ObjectId,不是字符串,类型不同就不相等。 - 修法:用
ObjectId('64f...')包一层;或者在客户端工具里直接复制它给出的ObjectId(...)写法。
4. 命令行里查一个集合,什么都不返回也不报错
- 现象:
db.sounds.find()空结果,怀疑数据丢了。 - 原因:多半是
Ctrl+C退出后重连,db回到了默认的test,test里根本没有这个集合——集合不存在时查询是静默返回空的。 - 修法:任何操作前先
db看一眼当前库,再use project02;show collections确认集合在不在。养成"先定位、再操作"的顺序。
5. 写 Mongoose 时,连接还没建立就去查数据
- 现象:
connect写在前面,Model.find()写在后面,报错或拿到空结果,偶尔又正常。 - 原因:连接是异步的,
connect()调用返回不代表已连上,后面的代码会立刻执行。 - 修法:把增删改查全部放进
mongoose.connection.on('open', ...)的回调里(或await mongoose.connect()之后再写),并补上on('error')打印错误。
6. Schema 里定义了 Number,插入时传了数组或非数字字符串
- 现象:
create回调拿到 error,文档没进库。 - 原因:Mongoose 会尝试类型转换,能转就转(
'18'→18),转不动就报错([1,2]、'hello'→18失败)。 - 修法:按 Schema 声明的类型传值;确实需要存别的类型就改 Schema,而不是硬塞。反过来也要注意:能转成功不代表你写对了,字符串
'18'悄悄变成数字很容易掩盖问题。
7. 按教程装了 mongoose 7,却照着回调写法写
- 现象:
create({...}, (err, doc) => {})里的回调永远不执行。 - 原因:7.x 移除了回调支持,只认 Promise。
- 修法:要么按笔记装 6.x(
npm i mongoose@6),要么改写成await/.then()。不要两个版本混着试。
练习
练习 1:库与集合的可见性验证 新建 shop 库,不做任何建集合操作,先 show dbs 记录结果;再建一个 orders 集合,重新 show dbs。把两次输出贴出来,用一句话说明差异原因。最后用 db.dropDatabase() 删掉它——删之前先用 db 确认一次当前所在库。
练习 2:两种更新方式对比 在 users 集合里插入两条 {name:'张三', age:20, address:'上海'}。分别用 update({name:'张三'},{address:'北京'}) 和 update({name:'张三'},{$set:{address:'北京'}}) 执行一次,每次执行完用 find() 看完整结果,记录两次的字段差异,并说明为什么生产环境只能用后者。
练习 3:查询条件组合 用歌曲集合(sounds)完成三个查询:① 时长在 150 到 300 之间(含端点);② 作者是"蔡徐坤"或"林宥嘉",且语言是"国语";③ 作者字段中包含"蔡"字(用正则)。每个查询后面接 .count() 报出数量。
练习 4:Mongoose 六步流程跑通 从零写一个 app.js:连接 mongodb://127.0.0.1:27017/shop,监听连接成功/失败事件,定义 Schema(商品名 String、价格 Number、上架时间 Date),创建 Model,在连接成功的回调里插入一条数据并打印返回的文档。要求:故意把价格传成字符串 '99',观察库里存的是什么类型,再改传 'abc' 看报什么错。
练习 5:客户端交叉验证 用 Compass(或 Robo 3T)连上本地服务,找到你在练习 4 里插入的那条文档,用表格视图确认字段类型;然后在该工具的内置 shell 里直接执行 db.goods.find(),验证结果与 Node 程序写入的一致。最后在工具里删除这条文档,回到 Node 程序查询,确认删掉了。
原视频对照
| # | 视频 | 时长 |
|---|---|---|
| 1 | 命令行操作-数据库操作 | 07:59 |
| 2 | 命令行操作-集合操作 | 04:29 |
| 3 | 命令行操作-文档操作 | 16:51 |
| 4 | 命令行操作-查询条件 | 22:26 |
| 5 | 图形化数据库客户端工具 | 15:46 |
| 6 | mongoose介绍 | 15:08 |
| 7 | mongoose操作步骤 | 26:20 |
小结
- 命令行这一遍不是为了记住命令,而是为了建立"后端到底在干什么"的直觉。 命令记录会给你,忘了就查;但"连接 → 定位库 → 定位集合 → 操作文档"这个动作顺序必须长在手上。
show dbs看不到 ≠ 没创建成功。 库、集合、文档是三层的从属关系,空库不显示、集合不存在时查询静默返回空——这两个"沉默行为"是新手最容易误判的地方,判断存在性要用对应的层级命令。- "替换整个文档"和"改某个字段"是两件完全不同的事,这是命令行阶段最容易踩且后果最直接的坑,
$set不是可选项。这个认知会一路带到 Mongoose 的updateOne。 - 类型意识要提前建立。
_id是 ObjectId 不是字符串,Schema 声明的类型会做隐式转换、转不动就报错——能转成功不代表你写对了,别让隐式转换替你掩盖问题。 - 命令行、图形化客户端、Node 程序,三者生态位完全等价,都是向同一个 MongoDB 服务发指令的客户端。理解了这一点,就不会把它们当成三套需要分别学的东西。
- Mongoose 的六步流程是固定骨架:导入 → 连接 → 监听事件 → Schema → Model → 用 Model 操作。同一个集合无论做增删改查,前五步只写一次,第六步换方法名即可。
- 异步是这个阶段的主旋律。 连接是异步的,所有数据库操作都是异步的,所以操作必须写在连接成功的回调里,而不是
connect()的下一行。 - Schema 是 Mongoose 相对原生命令行最核心的增量,它把"集合里文档结构应该统一"这件本该由人自觉遵守的事,变成了代码层面的约束。前面命令行阶段随便插、结构不一致也没事,那是演示;真做项目必须规范。