主题
Node 概述与安装和使用(Day6 1/3)
本页对应 Day06_Node,共 5 段视频,约 1 小时 56 分。
学习目标
- 能够复述 Git 本地仓库与远程仓库的核心操作流程,并独立完成添加暂存、提交、撤销修改、版本回滚、分支创建/切换/合并及冲突解决。
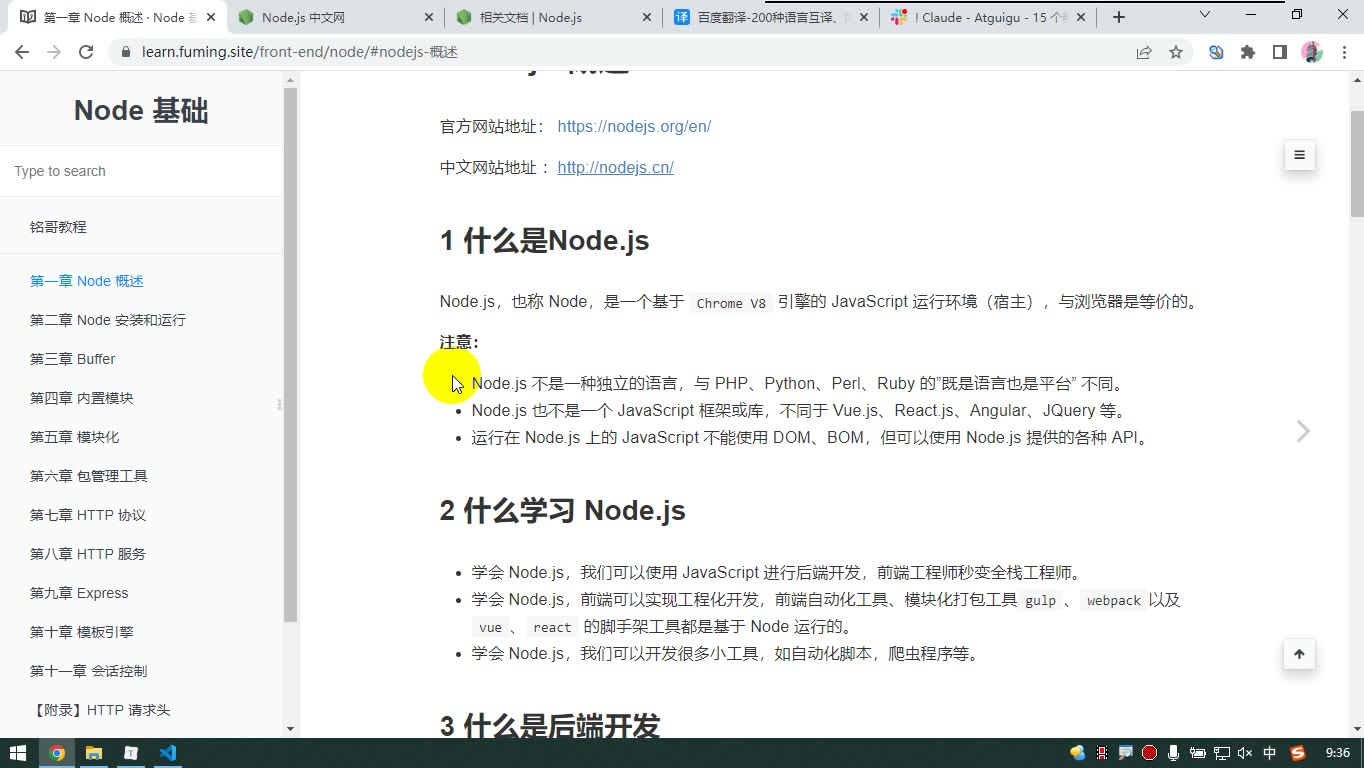
- 能够说明 Node.js 是基于 V8 引擎的 JavaScript 运行环境,并区分其与浏览器运行环境在可用 API 上的差异,明确 Node 中不能直接使用 BOM 和 DOM。
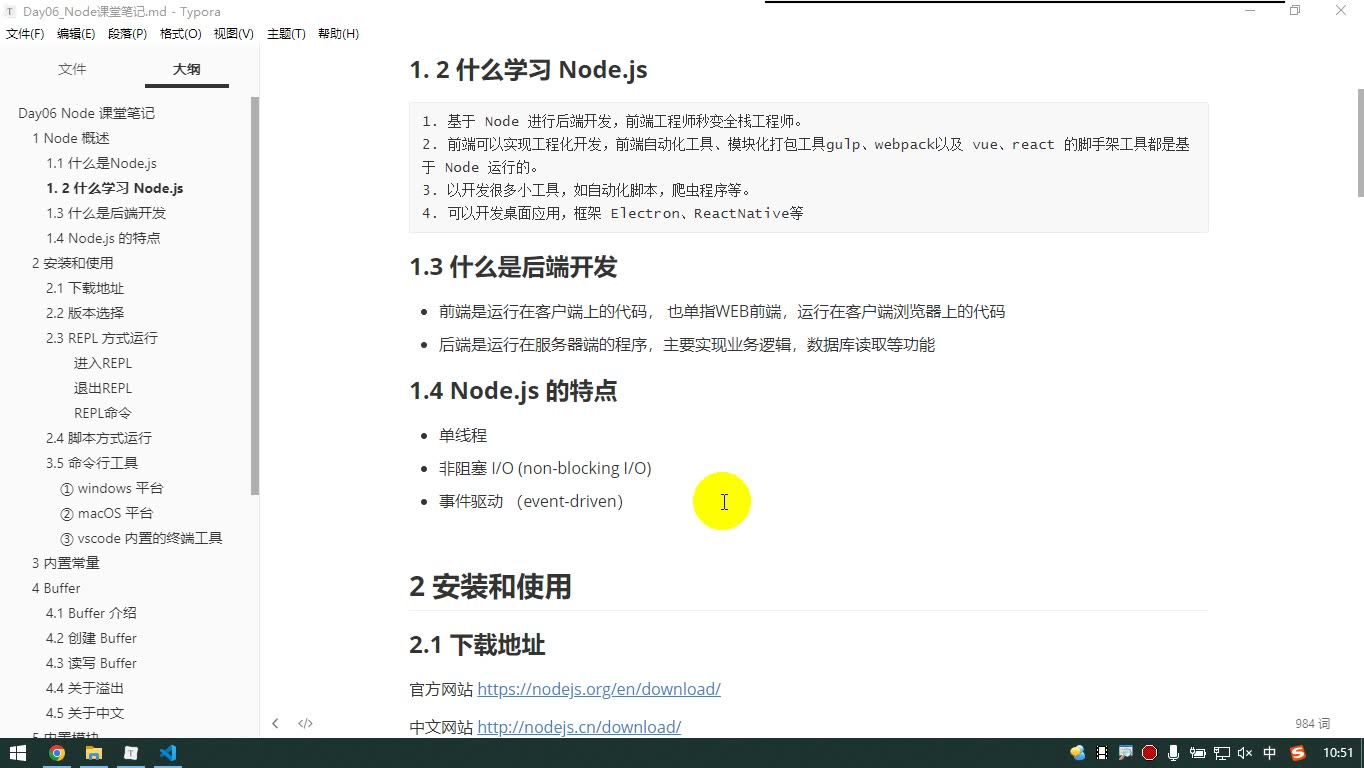
- 能够列举 Node.js 的典型应用场景,包括后端开发、前端工程化、自动化小工具和桌面应用开发,并说明其与前端工程化工具的关系。
- 能够对比前后端开发在运行位置、数据访问权限、兼容性考虑和部署环境上的差异,并说明 Web 服务器程序与数据库在后端架构中的作用。
- 能够解释 Node.js 单线程、事件驱动、非阻塞 I/O 的特点,并判断其适合与不适合的业务场景。
- 能够根据给定任务选择本地仓库操作、远程同步方式或 Node 应用方向,并说明选择依据。
知识点
一、Git:先把本地版本管理用顺,再谈远程协作
为什么需要: 代码会反复修改,一个人也可能把功能改乱;多人协作时还要避免互相覆盖。Git 的价值是让每次提交成为可回退的版本,并用分支隔离风险。转写稿强调:不要死记步骤,记住 add → commit → push 的主线,理解“本地仓库”和“远程仓库”两大块即可。
怎么想: 本地操作不需要联网,包括仓库配置、初始化、添加暂存、提交、撤销、查看记录、版本回滚、分支管理和忽略文件;远程操作才涉及代码托管平台、推送、拉取和克隆。一个人开发也有必要用 Git:能备份、能回到过去,也能用功能分支试验购物车等功能,确认无误再合并。
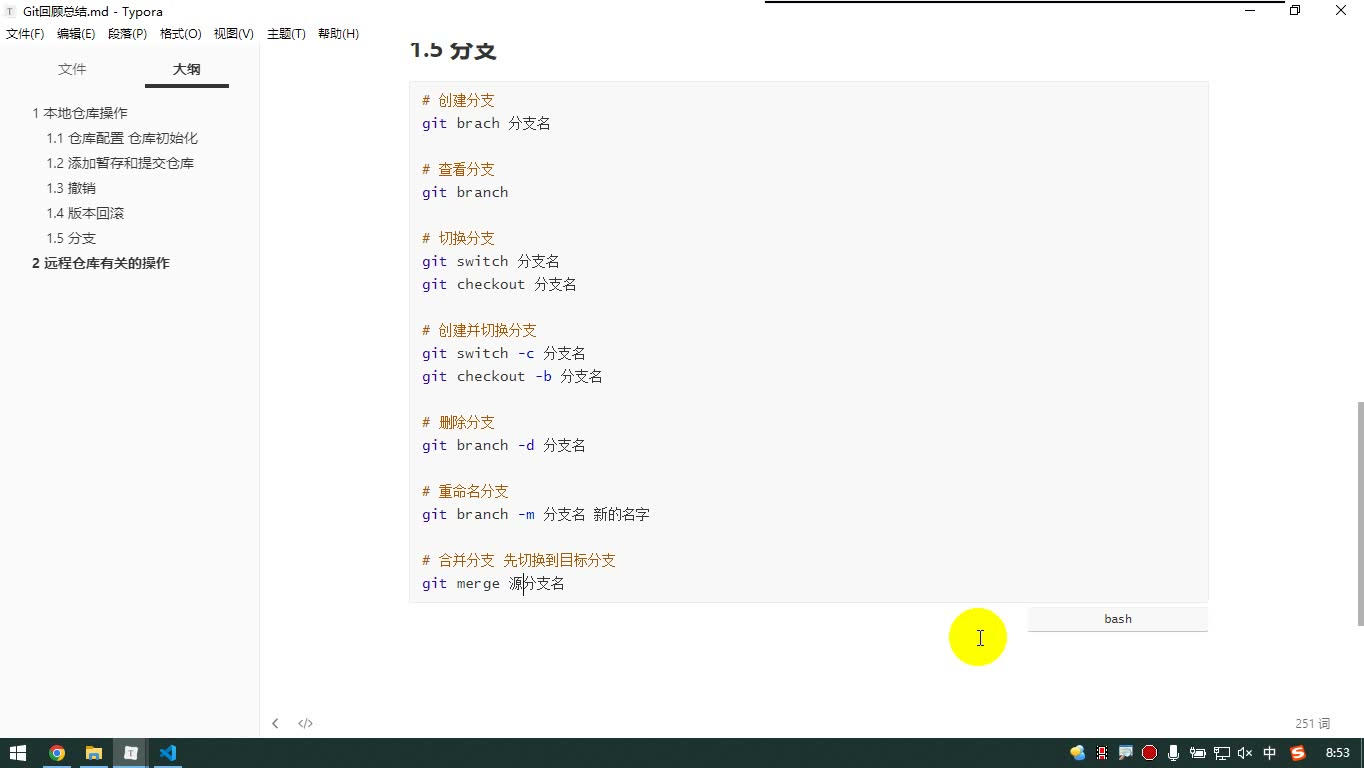
怎么做: 常见命令如下(仅保留关键流程):
bash
git add .
git commit -m "说明本次更新"
git push撤销未暂存修改可用 git restore;已暂存可先取消暂存再恢复修改;查看历史用 git log,回滚用 git reset --hard <commit ID>,回滚后想找回被回滚记录用 git reflog。分支用 git branch、git switch、git merge;忽略文件写入 .gitignore。远程首次同步分两种:本地有仓库则 git remote add origin <地址> 后 git push -u origin 分支;本地无仓库则 git clone <地址>,克隆会自动添加 origin。
易错点: 转写稿中提到的真实坑是:提交信息误写邮箱,本地提交正常,推送远程时可能被平台判定泄露隐私而失败。合并冲突时必须手动修改冲突文件,再 git add、git commit;冲突未解决时不能推送。.gitignore 对已提交文件不自动生效,需先取消跟踪。checkout 旧命令既能撤销又能切分支,容易混用,课上更推荐 restore 和 switch。
二、Node.js 是什么:JavaScript 的运行环境
为什么需要: 之前写的 JS 都跑在浏览器里,离开浏览器就需要新的“宿主”。Node.js 让 JS 可以脱离浏览器运行,因此前端工程师也能接触后端和工程化工具。
怎么想: 编程语言还是 JavaScript,Node.js 不是新语言,也不是框架或库。它和浏览器一样,都是 JS 的运行环境(宿主/解释器),只是提供的 API 不同。浏览器提供 BOM、DOM;Node 提供自己的 API。所以运行在 Node 上的 JS 不能使用 window、document 等浏览器 API。
怎么做: 到官网下载安装 Node.js,之后用 node 文件名.js 运行脚本。学习时把 JS 基础、内置对象、高级原理继续沿用;把 BOM/DOM 替换成 Node 提供的文件、网络等能力。原始网址保留如下:
text
https://nodejs.org/en/
http://nodejs.cn/易错点: 不要把 Node.js 和 Vue、React 混为一谈:Vue/React 是用 JS 写的框架,Node 是运行环境。也不要在 Node 里找 document。中文文档适合查阅 API,不适合从零当教程读;中文网可能是网友维护,存在停更可能。
三、Node.js 的用途:后端、前端工程化、小工具与桌面应用
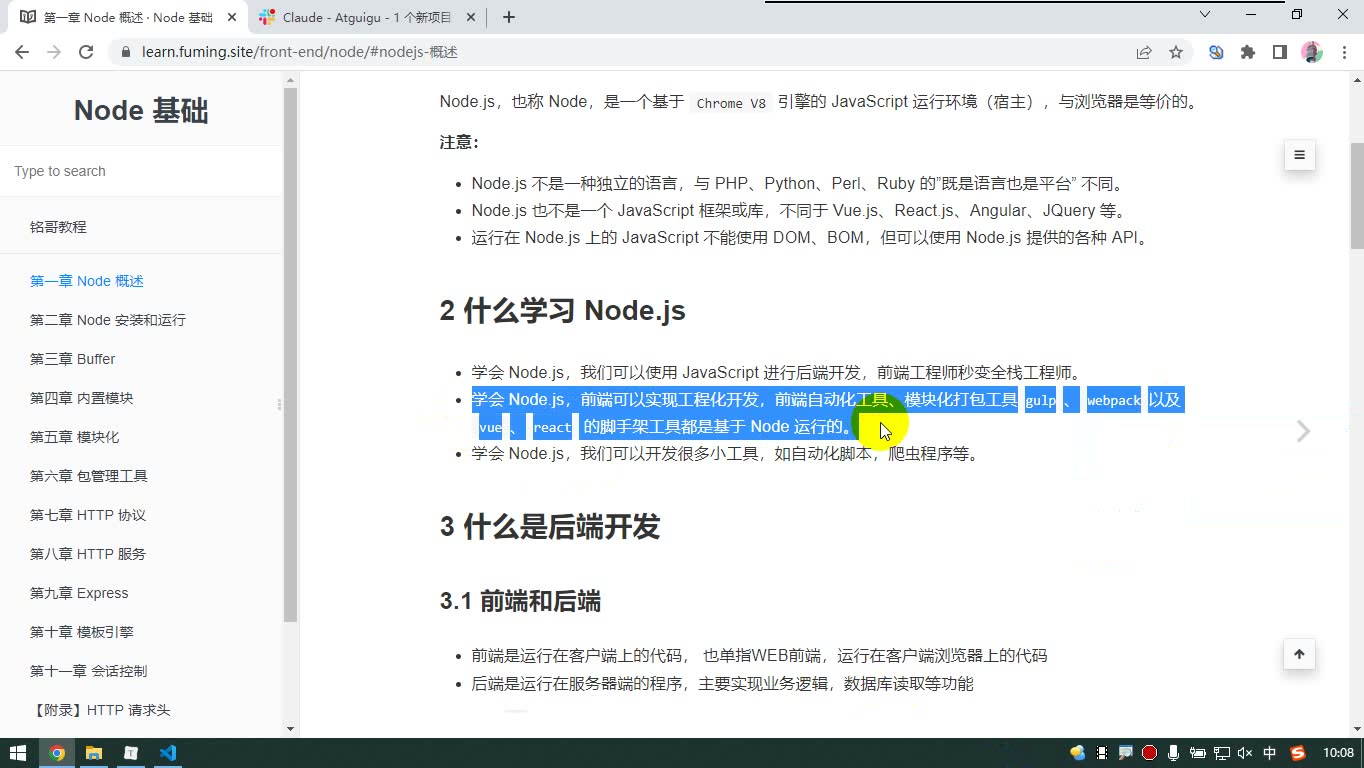
为什么需要: 前端项目需要把 Less 编译成 CSS、压缩代码、处理模块化、提高兼容性;这些工具需要一个运行环境。Node 的出现让 JS 能脱离浏览器,工具便可以在电脑上运行。
怎么想: 前端工程化工具大多运行在 Node 上,脚手架也基于 Node。你未必要写 Node 工具代码,只要安装 Node、安装并配置工具即可。除此之外,Node 还能写后端服务、自动化脚本、爬虫、小工具,甚至桌面应用;但大型计算型后端仍常由 Java、C/C++ 等承担,Node 常处在更靠前、更轻量的层次。
怎么做: 先安装 Node,再使用基于 Node 的自动化/打包工具;写后端时让 Node 程序运行在服务器上;写脚本时用 Node 操作文件、发请求、处理数据。桌面应用有对应框架,但课上只作了解。
易错点: “会用 Vue 开发”不等于“会写 Node 工具”;很多工具只需配置。爬虫要抓公开数据并注意合规,不能把浏览器安全限制当成不存在。Node 适合轻量、I/O 频繁场景,不要误以为它能无条件替代 Java 大型后端。
四、前后端对比:请求—响应与数据边界
为什么需要: 页面上的商品数据不是写死的,而是来自数据库并会更新。浏览器不能直接读服务器数据库,否则隐私和安全都无法保证,所以需要后端程序在服务器上读数据、处理后再响应给前端。
怎么想: 前端运行在客户端浏览器,后端运行在服务器。浏览器输入网址后发出请求,服务器上的 Web 服务器程序或 Node 程序接收请求,后端程序访问数据库、处理业务,再返回 HTML/CSS/JS 或数据。前端拿到后在浏览器运行;需要新数据时再向后端请求。
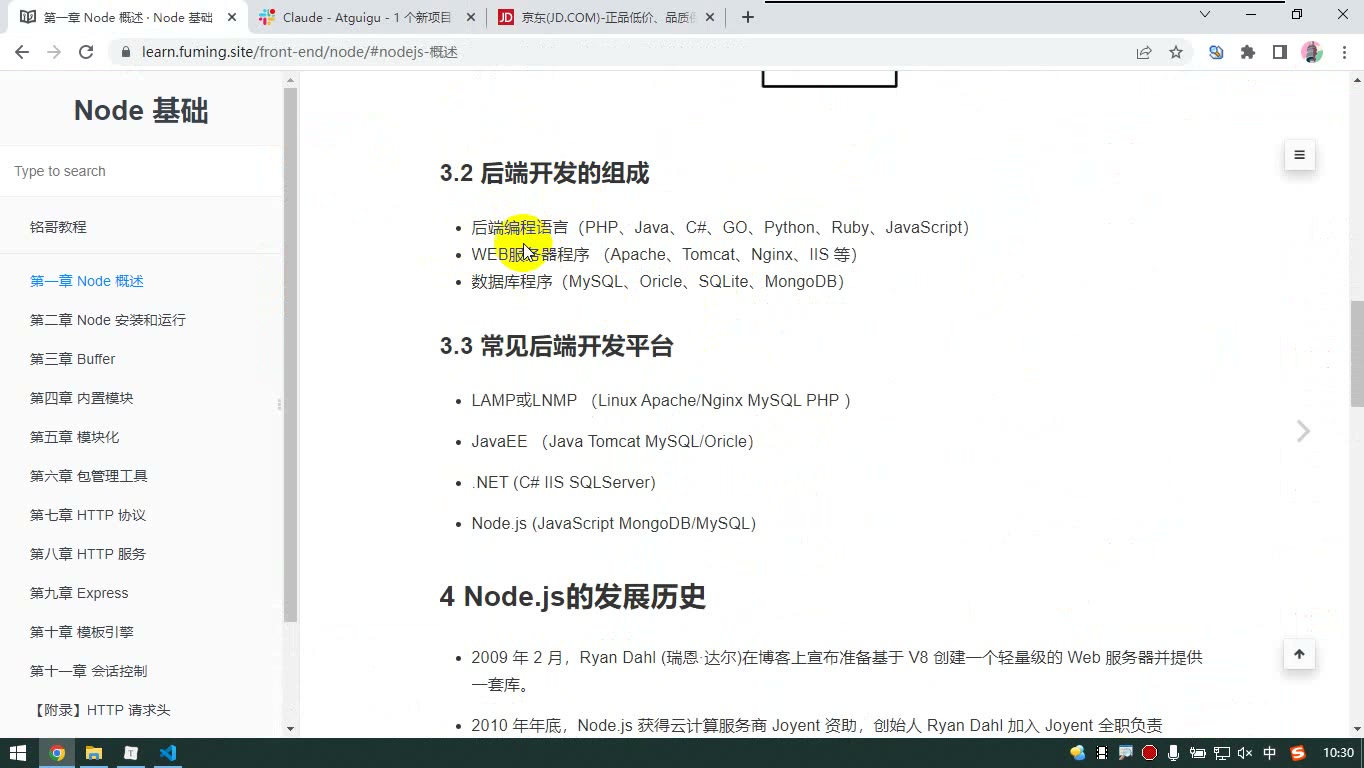
怎么做: 理解“请求→后端处理→响应”的链路;后端可能需要安装 Node、Web 服务器程序(如 Apache、Nginx、Tomcat)和数据库(课上提到 MongoDB 与 Node 配合较多)。Node 程序运行在自己的服务器上,因此不必像浏览器那样考虑用户浏览器兼容性。
易错点: 浏览器 JS 不能直接读本机文件或服务器数据库;这是安全限制,不是语法问题。Node 不需要重点考虑“用户用哪个浏览器”,因为版本和运行环境由开发者控制。数据库、Web 服务器、后端程序是不同层,不要混成一个概念。
五、Node.js 特点:单线程、非阻塞、事件驱动
为什么需要: 高并发访问时,传统“每请求创建进程”的方式开销大。转写稿用估算说明:若每进程至少约 2MB 内存,8GB 内存大约只能支撑四千左右并发;而 Node 用单线程加事件队列,减少额外进程/线程开销,极限测试可到十几万并发。
怎么想: Node 是单线程、事件驱动、非阻塞:请求像事件进入队列,线程空闲就处理,不阻塞等待 I/O。这样能把计算机性能用得更充分,适合轻量、I/O 密集的操作。
怎么做: 写 Node 程序时避免长时间同步阻塞;把耗时操作交给异步 I/O。理解事件循环与队列即可,不必一开始深挖底层。
易错点: 单线程的缺点是稳定性风险:一个请求或异常导致进程崩溃,可能“一起崩”。因此 Node 不适合计算量巨大的任务;高并发不等于无条件稳定。实际大型系统会分层,Node 可能只负责靠前的一层。
六、远程验证与学习入口
为什么需要: 远程仓库要稳定登录;文档要能随时查 API。转写稿中 HTTPS 在不同系统上常出现账号密码输入差异,SSH 更稳定。
怎么想: HTTPS 用账号密码;SSH 用公钥/私钥,把本机公钥配置到远程账号上。远程地址要选 SSH 地址,不要和 HTTPS 混用。
怎么做: 配置 SSH 后测试推送/拉取;日常流程是“先拉取,再推送”,即先 pull 再 push。学习时收藏 Node 官网和中文网,遇到 API 忘记再查。
易错点: 远程地址选错协议会导致验证失败;推送前不拉取,别人先推送后你直接推送会失败,应先拉取、解决冲突、再提交推送。标准 Git Flow 和“一把梭”模式课上只作了解,先把 add → commit → push 与冲突处理练熟。
先把 Node.js 的定位摆正
为什么需要:初学者最容易把 Node.js 当成一门新语言,或者当成类似 Vue、React 的框架,结果后面一学就乱。怎么想:Node.js 的全称是 Node.js,常简称 Node,它的本质是“基于 V8 引擎的 JavaScript 运行环境”。也就是说,JavaScript 还是那门 JavaScript,只是过去主要在浏览器里跑,现在也可以放到 Node 里跑。怎么做:把 Node 和浏览器看成两个并列的“宿主/运行环境”,二者都能解释执行 JavaScript。易错点:Node 不是 JavaScript 的框架或库,不是独立语言;Vue、React 是用 JavaScript 写的框架,和 Node 不是一回事。写 Node 程序时,代码仍然是 JavaScript。
浏览器与 Node:同一语言,不同 API
为什么需要:理解“为什么浏览器里能用的东西,到 Node 里未必能用”。怎么想:运行环境不仅负责运行代码,还提供一套可调用的 API。浏览器提供 DOM、BOM 等 API;Node 提供自己的 API。怎么做:在浏览器项目里操作 window、document;在 Node 程序里使用 Node 提供的文件、网络等能力。易错点:在 Node 里找 window、document,会失败;反过来,也不能把 Node 专属 API 直接拿到浏览器里用。还要注意,Node 程序通常运行在自己的电脑或服务器上,不像浏览器代码运行在用户电脑上,所以浏览器出于隐私和安全做了很多限制,而 Node 没有那套浏览器限制。但不能因此理解成“Node 什么都能随便干”,而是它运行位置不同、约束不同。
Node 为什么是前端工程化的基础
为什么需要:前端项目里常写 Less、模块化代码、ES6 语法,还希望压缩代码,但浏览器并不直接全部认识。怎么想:这些工作要靠构建、打包、自动化工具完成,而这些工具大多运行在 Node 上。怎么做:电脑安装 Node 后,安装并使用相应工具;Vue、React 的脚手架工具也建立在 Node 基础之上。易错点:不要以为学 Node 就是要自己开发一套工具;对多数前端开发者来说,先会安装、配置、使用工具即可。也不要以为“不会 Node 也能直接上 Vue/React 工程化”,脚手架和构建流程离不开 Node。
Node 能做什么:后端、工具与桌面应用
为什么需要:知道学习 Node 的实际价值。怎么想:JavaScript 脱离浏览器后,可以写后端服务,也可以写自动化脚本、爬虫等小工具,还能借助桌面应用框架做桌面程序。怎么做:服务器上安装 Node,运行后端程序;本机安装 Node,运行各类工具;桌面框架基于 Node/JavaScript 生态。易错点:不要把 Node 当成能包打天下的后端方案。大型后端往往分层,Node 常负责较靠前、较轻量、I/O 较多的部分;计算量巨大的任务并不适合 Node。也不要误以为学了 Node 就一定做后端工程师,前端开发者更多是借它理解流程、使用工程化工具。
前后端到底差在哪
为什么需要:理解 Node 写后端时“程序在哪里跑”。怎么想:前端代码运行在客户端浏览器,后端代码运行在服务器;数据库通常在服务器上,浏览器不能直接读数据库。怎么做:浏览器向服务器发请求,Web 服务器程序接收并转发请求,后端程序处理业务、读取数据库,再把 HTML/CSS/JS 或数据响应给前端。易错点:以为前端 JavaScript 能直接读服务器数据库;忽略 Web 服务器程序的作用;把“我写的代码”误认为一定在我电脑上运行。前端是“我写,但在用户浏览器跑”;后端是“我写,在我的服务器跑”,这是关键区别。
单线程、事件驱动、非阻塞
为什么需要:解释 Node 为什么能扛较多并发,又为什么有稳定性风险。怎么想:Node 常被概括为单线程、事件驱动、非阻塞。请求来了进入队列,线程空闲就处理;课堂用简化模型对比 Apache:Apache 可能为请求创建进程,进程有内存开销;Node 不靠大量进程/线程堆并发。怎么做:把 Node 用在 I/O 较多、较轻重量的场景;避免把重计算任务硬塞进去。易错点:单线程不等于“只能一个用户访问”,而是处理机制不同;高并发优势不代表万能,一旦某个请求导致进程崩溃,影响面可能很大;非阻塞也不是没有代价。理解这些特点,才能判断 Node 适合什么、不适合什么。
先分清:Node 是运行环境,不是语言
为什么需要:浏览器能运行 JavaScript,但前端工程化工具、后端程序、自动化脚本不能只靠浏览器。要让 JS 脱离浏览器运行,就需要一个新的宿主环境。
怎么想:转写稿里反复强调,Node.js 是“基于 V8 引擎的 JavaScript 运行环境”,也可以简称 Node。它和浏览器是并列关系:浏览器是 JS 的运行环境,Node 也是 JS 的运行环境。编程语言仍然是 JavaScript,换的是“运行的地方”和“能调用的 API”。
怎么做:学习时先把 Node 当成“宿主/运行环境”,不要当成一门新语言。你写的仍是 JS,只是从浏览器搬到 Node 里跑。
易错点:不要把 Node 当成 JavaScript 的框架或库,它和 Vue、React 完全不是一回事;也不要以为“装了 Node 就会写后端”,Node 只是让你具备写后端程序的环境。
安装入口:官网和中文文档要分清
为什么需要:安装 Node 需要下载对应操作系统的安装包;学习 API 时需要查文档。转写稿提到官网默认英文,但可以切换简体中文;中文网文档是纯中文,适合查询。
怎么想:官网负责下载和语言切换,中文网更像“手册/词典”,不是从头到尾的教程。明确说,这种文档是参考文档,用来查某个东西有哪些方法、怎么用,不是靠它系统入门。
怎么做:打开 Node 官网或中文网,进入下载页,按 Windows、macOS、Linux 选择对应版本,下载安装包并按向导安装。安装后,后续工程化工具才有运行基础。
易错点:不要下载错操作系统版本;不要把中文文档当教程硬读,否则容易不知道它在讲什么;中文网很多是网友维护,可能更新不及时,查不到时回到官方文档。
安装后先理解使用边界:哪些 JS 能用
为什么需要:Node 和浏览器虽然都跑 JS,但提供的 API 不同。不先分清边界,就会把浏览器代码直接搬到 Node 里报错。
怎么想:转写稿说得很清楚:JS 基础、内置对象、高级部分里的执行上下文、继承机制、线程机制和事件轮询等,属于语言和底层原理,Node 里也能用;但 BOM 和 DOM 是浏览器提供的 API,Node 里不能用。Node 环境提供的是 Node 自己的 API。
怎么做:写 Node 程序时不要写 window、document 这类浏览器对象;需要文件、网络、进程等能力时,查 Node 文档用 Node API。前端页面代码仍然放回浏览器运行。
易错点:看到 window is not defined 一类错误,不一定是安装失败,而是运行环境不对;不要以为“JS 代码在哪都能原样跑”。
用 Node 能做什么:后端、工程化、小工具、桌面应用
为什么需要:知道用途,才知道安装 Node 后往哪里用。转写稿把用途归为几类:用 JS 做后端开发;做前端工程化;写自动化脚本、爬虫等小工具;开发桌面应用。
怎么想:前端工程化里的 Less 编译成 CSS、模块化打包、代码压缩、ES6 转 ES5 等,都需要工具;这些工具大多运行在 Node 上。也就是说,Node 是前端工程化的基础。后端程序则要运行在服务器电脑上,服务器也要安装 Node。
怎么做:先装 Node,再安装和配置具体工具;后端流程要理解“客户端请求—服务器程序—后端程序—数据库—响应”的关系。转写稿说数据库后续会用 MongoDB 打通流程,但当前先把环境和使用边界弄明白。
易错点:不要以为这些工程化工具都要自己开发,多数只需安装配置;不要以为 Node 会取代 Java 做大型后端,它更适合轻量、高并发、表层服务。
单线程非阻塞:优点和取舍
为什么需要:Node 的“单线程、非阻塞、事件驱动”决定了它适合什么、不适合什么。
怎么想:单线程处理所有请求,请求像事件一样进入队列,线程空闲就处理。相比 Apache 每个请求创建进程、每个进程有内存开销,Node 开销小,能把计算机性能发挥得更充分,并发能力更强;但一个线程出问题可能整体崩溃,计算量巨大时内存容易不够。
怎么做:轻量、高并发、I/O 较多的场景适合 Node;计算量巨大的任务不适合硬扛。理解这一点,后面学工程化和后端时才不会用错。
易错点:不要把“非阻塞”理解成多线程;不要只看高并发优点,忽略稳定性和计算密集型场景的短板。
课堂画面
代码示例
示例一:运行环境探测(浏览器端,可直接双击运行)
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>运行环境探测:浏览器 vs Node</title>
  <style>
    body { font-family: system-ui, sans-serif; padding: 24px; background: #f7f7f7; }
    #box { background: #fff; border: 1px solid #ddd; border-radius: 8px; padding: 16px; line-height: 2; }
    .ok { color: #1a7f37; font-weight: 700; }
    .no { color: #c62828; font-weight: 700; }
  </style>
</head>
<body>
  <h2>当前这段 JS 跑在哪个运行环境?</h2>
  <div id="box"></div>

  <script>
    const box = document.getElementById('box');

    // 浏览器(宿主)提供的 API:BOM / DOM
    // Node(宿主)提供的 API:global / process / require
    const checks = [
      ['window 对象',        typeof window !== 'undefined'],
      ['document 对象',      typeof document !== 'undefined'],
      ['localStorage',       typeof localStorage !== 'undefined'],
      ['全局对象 global',    typeof global !== 'undefined'],
      ['process 对象',       typeof process !== 'undefined'],
      ['require 函数',       typeof require !== 'undefined']
    ];

    checks.forEach(function (item) {
      const name = item[0];
      const has  = item[1];
      const p = document.createElement('p');
      p.innerHTML = name + ':<span class="' + (has ? 'ok' : 'no') + '">'
                  + (has ? '有' : '没有') + '</span>';
      box.appendChild(p);
    });
  </script>
</body>
</html>关键行与易错点
typeof window !== 'undefined'是判断“当前宿主是不是浏览器”的标准写法;直接用if (window)在 Node 里会抛ReferenceError,必须用typeof才不会报错。- 页面在浏览器里打开时,
window / document / localStorage全部为“有”,global / process / require全部为“没有”——正好印证课上讲的:Node 不是一种新语言,JS 还是那门 JS,变的只是宿主提供的 API。 - 反过来,把这段逻辑放到
.js文件里用node xxx.js跑,前三项会全变“没有”,后三项变“有”。这是最容易懵的地方:同一段判断代码,两个环境下结果完全相反。 typeof require在 Node 的 ESM 模块(.mjs)里也是undefined,别拿它当唯一判据。
示例二:Node 读写文件 + 非阻塞(保存为 demo.js,node demo.js 运行)
js
// demo.js —— node demo.js
const fs = require('fs');
const path = require('path');

const file = path.join(__dirname, 'note.txt');

// 1. 写文件:浏览器里的 JS 被安全限制,根本做不到这件事
fs.writeFileSync(file, '这是 Node 写入的第一行\n这是第二行\n', 'utf8');

// 2. 同步读取
const content = fs.readFileSync(file, 'utf8');
console.log('【同步读取】\n' + content);

// 3. 异步(非阻塞)读取:Node 单线程 + 事件驱动的体现
console.log('1 开始');
fs.readFile(file, 'utf8', function (err, data) {
  if (err) {
    console.error('读取失败:', err.message);
    return;                       // 回调里必须 return,否则会继续往下走
  }
  console.log('3 回调里拿到数据:' + data.trim());
});
console.log('2 结束(没有等文件读完就往下执行了)');

// 4. 用同步写做对比:它会“卡住”后面的代码
console.log('4 同步写文件,这行一定要等写完之后才打印');
fs.writeFileSync(path.join(__dirname, 'log.txt'), 'done', 'utf8');关键行与易错点
require('fs')/require('path')是 Node 提供的内置模块,浏览器里没有,这就是课上说的“不同运行环境提供不同 API”。fs.readFileSync是同步、fs.readFile是异步。观察输出顺序是1 → 2 → 4 → 3,说明异步读取期间主线程没被卡住,这正是 Node 单线程靠事件驱动把性能榨到极致的原因。- 易错点:异步回调里
if (err) { ... }后必须return,否则后面的代码照样执行,拿到data为undefined,一trim()就崩。 - 易错点:
__dirname是 Node 的全局变量(当前文件所在目录),浏览器里没有;用相对路径'./note.txt'时,路径是相对执行命令的目录而不是文件所在目录,容易读不到文件。 - 全篇没有任何
window、document,说明 Node 里 BOM/DOM 用不了,能用的只有 Node 自己那套 API。
示例三:用 Node 写一个最小后端(node server.js 后访问 http://localhost:3000)
js
// server.js —— node server.js
const http = require('http');

const server = http.createServer(function (req, res) {

  // 接口:模拟“后端从数据库取数据,处理后再返回给前端”
  if (req.url === '/api/goods') {
    res.writeHead(200, { 'Content-Type': 'application/json; charset=utf-8' });
    res.end(JSON.stringify({
      code: 0,
      data: [{ id: 1, name: '茅台', stock: 500 }]
    }));
    return;                       // 接口处理完必须 return,否则会继续走下面的页面分支
  }

  // 页面:后端把 HTML/CSS/JS 分发下去,由浏览器负责运行
  res.writeHead(200, { 'Content-Type': 'text/html; charset=utf-8' });
  res.end(`<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>Node 后端</title>
  <style>
    body { font-family: system-ui, sans-serif; padding: 24px; }
    li { line-height: 2; }
  </style>
</head>
<body>
  <h2>数据来自 Node 后端</h2>
  <ul id="list"><li>加载中…</li></ul>

  <script>
    fetch('/api/goods')
      .then(function (r) { return r.json(); })
      .then(function (json) {
        document.getElementById('list').innerHTML = json.data.map(function (g) {
          return '<li>' + g.name + ',库存 ' + g.stock + '</li>';
        }).join('');
      });
  </script>
</body>
</html>`);
});

server.listen(3000, function () {
  console.log('服务已启动:http://localhost:3000');
});关键行与易错点
http.createServer就是课上说的“接收客户端请求、做出响应”的那个角色。以前要装 Apache/Nginx 才有这层能力,Node 里几行代码就自带一个 web 服务。- 请求
/返回 HTML/CSS/JS,由浏览器去运行;请求/api/goods返回 JSON,由服务器处理——这就是前后端分工:前端跑在客户端,后端跑在服务端。 - 易错点:接口分支里忘了
return,会继续执行下面的res.writeHead,浏览器报ERR_HTTP_HEADERS_SENT(响应头已发送)。 - 易错点:
res.end()只传字符串;想返回对象必须JSON.stringify,否则前端r.json()解析失败。中文要显式写charset=utf-8,不然乱码。 - 易错点:
listen(3000)端口被占用会抛EADDRINUSE,换端口即可;改完代码要Ctrl + C停掉再重新node server.js(Node 不会自动热更新)。 - 课上强调的“单线程、一崩全崩”在这里能直观感受:这个进程一挂,所有正在访问的客户端同时断掉,没有 Apache 那种“一请求一进程、崩一个不影响别人”的隔离性。
常见错误
现象: 本地
commit正常,推送远程却失败。
原因: 提交信息里写了邮箱等隐私内容,远程平台拦截。
修法: 提交信息只描述本次变更;已写入的用commit --amend修正后再推送。现象: 合并分支后命令都执行不了,推送也被拒绝。
原因: 两个分支改了同一文件,处于冲突未解决状态。
修法: 打开冲突文件手动决定保留内容,重新add、commit,再继续推送。现象: 多人协作时直接
push报失败。
原因: 远程已有别人更新的提交,本地不是最新。
修法: 先pull,有冲突先解决并提交,再push;养成“先拉后推”的习惯。现象: 配了 SSH 却仍然提示账号密码或认证失败。
原因: 远程地址仍用 HTTPS,或公钥未正确配置到平台账号。
修法: 确认远程地址为 SSH 地址;检查本机公钥是否已添加到代码托管平台。现象: 在 Node 代码里使用
window、document、localStorage报未定义。
原因: 把浏览器提供的 BOM/DOM API 当成 JS 语言本身能力。
修法: Node 环境只用 Node 提供的 API;浏览器专属 API 放回前端代码中。现象: 认为“学了 Node 就是学了一个 JS 框架/库”,或把 Node 与 Vue/React 混为一谈。
原因: 没区分运行环境、编程语言、框架/库三者。
修法: 明确 Node 是 JS 运行环境;Vue/React 是用 JS 写的框架/库。现象: 文件已经提交到仓库后才写
.gitignore,发现忽略不生效。
原因:.gitignore只影响未被跟踪的文件。
修法: 先从版本库中删除跟踪记录,再提交忽略规则;正常项目应提前配置忽略文件。
练习
- 在本地新建仓库,完成两次提交;用
git log --oneline查看记录,再回滚到上一次提交,并用git reflog找回被回滚的记录。 - 模拟两人协作:A 先推送一次提交,B 基于旧版本提交后直接推送失败;请写出 B 从失败到成功推送的完整命令流程,并说明冲突时如何处理。
- 判断下列代码应放在浏览器端还是 Node 端,并说明理由:读取本地文件、操作
document、启动一个 HTTP 服务、使用localStorage。 - 用一句话向新人解释:为什么前端工程化工具、脚手架通常要先安装 Node?再举出两个笔记中提到的 Node 应用场景。
- 分别描述“本地有仓库、远程无仓库”和“本地无仓库、远程有仓库”两种首次同步场景的操作步骤,并指出哪一步会自动建立远程关联。
原视频对照
| # | 视频 | 时长 |
|---|---|---|
| 1 | Git回顾 | 48:40 |
| 2 | Node介绍 | 13:17 |
| 3 | Node的应用 | 19:12 |
| 4 | 前后端开发对比 | 26:39 |
| 5 | Node的特点 | 08:43 |
小结
- Git 日常高频动作可归纳为
add → commit → push,协作时牢记“先pull再push”。 - 冲突并不可怕,统一处理流程是:手动改文件 →
add→commit→ 继续推送。 checkout老教程常见,但新代码更推荐用restore撤销修改、switch切换分支。- Node 是 JavaScript 的运行环境,不是新语言,也不是 Vue/React 这类框架或库。
- Node 与浏览器都能运行 JS,但可用 API 不同:浏览器有 BOM/DOM,Node 提供自己的服务端能力。
- Node 的单线程、非阻塞、事件驱动特点决定了它适合轻量高并发场景,不适合重计算场景。
- 前端工程化工具和脚手架普遍运行在 Node 上;学 Node 不等于必须写 Node 后端,但必须理解其工具链地位。
- 远程仓库首次同步要区分“本地有、远程无”和“本地无、远程有”;克隆会自动完成远程地址关联。