主题
http 服务(Day9 1/2)
本页对应 Day09_Node,共 5 段视频,约 2 小时 5 分。
学习目标
- 能说明 npm 安装依赖与开发依赖的区别,并解释
package.json中入口文件、scripts、dependencies、devDependencies的作用。 - 能复述 HTTP 请求报文与响应报文的组成,列举请求行三要素、常见请求头及 200/304/403/404/500/503 等状态码含义。
- 能使用 Node.js 内置
http模块创建并启动 HTTP 服务,监听指定端口,并通过浏览器访问验证响应结果。 - 能使用
req.method、req.url、req.httpVersion获取请求行信息,使用req.headers获取请求头,使用req.socket.remoteAddress获取客户端 IP。 - 能使用
url.parse或new URL解析请求 URL 中的路径与查询字符串,并正确读取指定查询参数。 - 能通过地址栏或表单携带查询字符串发起请求,并在服务端读取参数后返回包含参数内容的响应以完成验证。
知识点
一、先回顾 npm 与 HTTP 协议:知道自己在操作什么
为什么需要:写 Node 服务端程序前,先要分清“包管理”和“网络通信”两件事。npm 解决依赖安装与版本记录,HTTP 协议解决浏览器和服务器之间“怎么发请求、怎么回响应”。
怎么想:npm install 会根据 package.json 安装依赖;安装某个包时默认写入 dependencies,如果只是开发阶段使用,就加 -D 写入 devDependencies。package.json 里重点关注入口文件、scripts、产品依赖和开发依赖。HTTP 侧要记住 IP、域名、端口、URL;请求报文由请求行、请求头、空行、请求体组成,响应报文由状态行、响应头、空行、响应体组成。
怎么做:请求行包含请求方法、URL、HTTP 版本;请求头是键值结构,例如 user-agent;请求体是客户端发给服务端的数据,调试时在浏览器“网络”里常看到“载荷”。响应状态码记住:200 成功,304 多用缓存,404 资源不存在,403 无权限,500 服务器错误,503 服务不可用。
易错点:req.url 不是完整 URL;请求体不是随便就能直接读;状态码和状态描述要对应,但调试时重点看状态码。
二、创建 HTTP 服务:createServer 与 listen
为什么需要:只有创建并启动 HTTP 服务,自己的电脑才能临时充当服务器,让浏览器向它发请求。
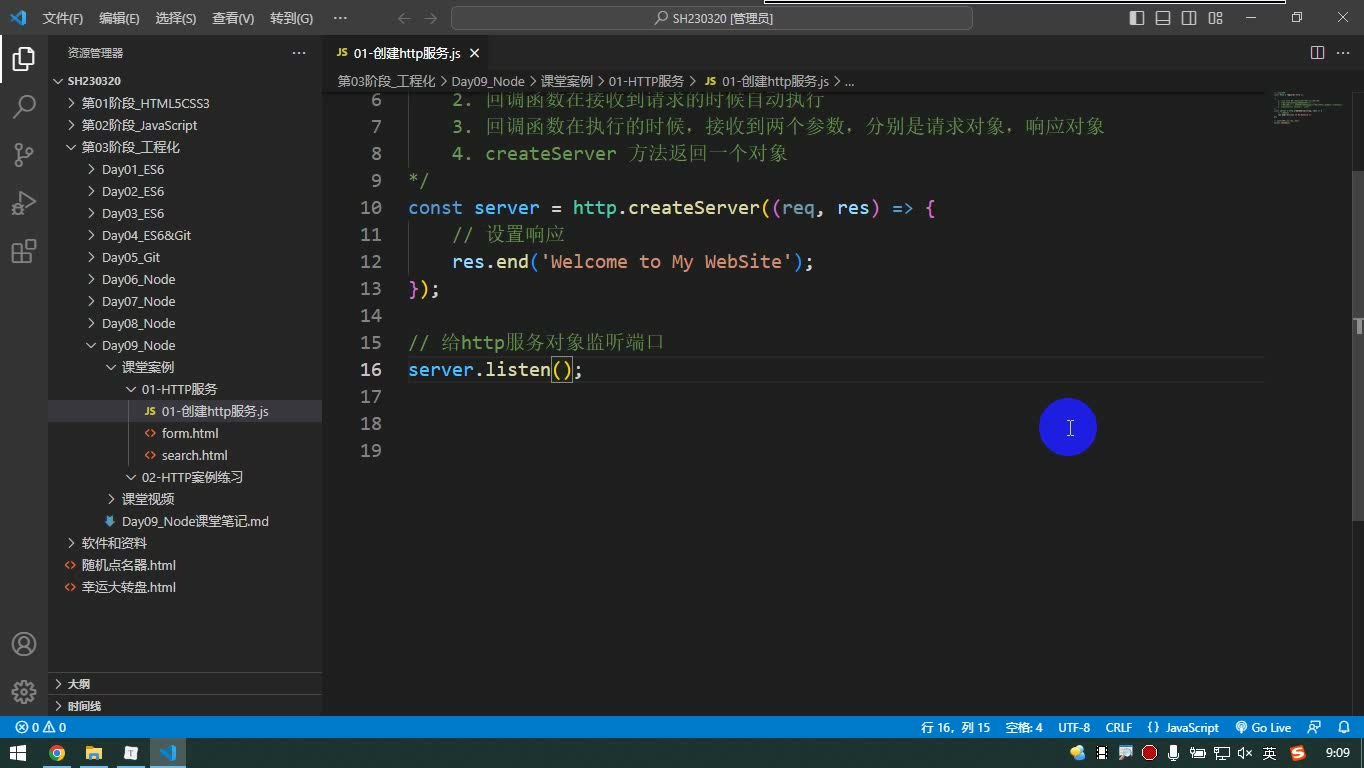
怎么想:Node 内置 http 模块,不需要额外下载。http.createServer 接收一个回调函数,这个回调不是立刻执行,而是在“接收到请求时”执行;执行时可拿到请求对象 req 和响应对象 res。createServer 返回服务对象,再调用 listen 监听端口,服务才算启动。
怎么做:
js
const http = require('http');

const server = http.createServer((req, res) => {
  res.setHeader('Content-Type', 'text/html; charset=utf-8');
  res.end('<h1>Welcome to my website</h1>');
});

server.listen(8080, () => {
  console.log('HTTP server is running on 8080');
});课堂现场先运行文件,发现没有输出 ok,因为回调要等请求到来才执行;启动成功后程序不会自动结束,会一直监听。改代码后要先 Ctrl + C 结束,再重新运行;开发时可用 nodemon 自动重启。
易错点:端口被占用会报 EADDRINUSE,可换端口,或用 netstat -ano | findstr 8080 找到进程号后结束进程;127.0.0.1 和 localhost 都表示本机;浏览器刷新时可能额外请求 favicon.ico,所以服务端回调可能执行两次。
三、获取请求行、请求头和客户端 IP
为什么需要:服务端要知道“谁用什么方式请求了什么地址”,才能做路由和日志。
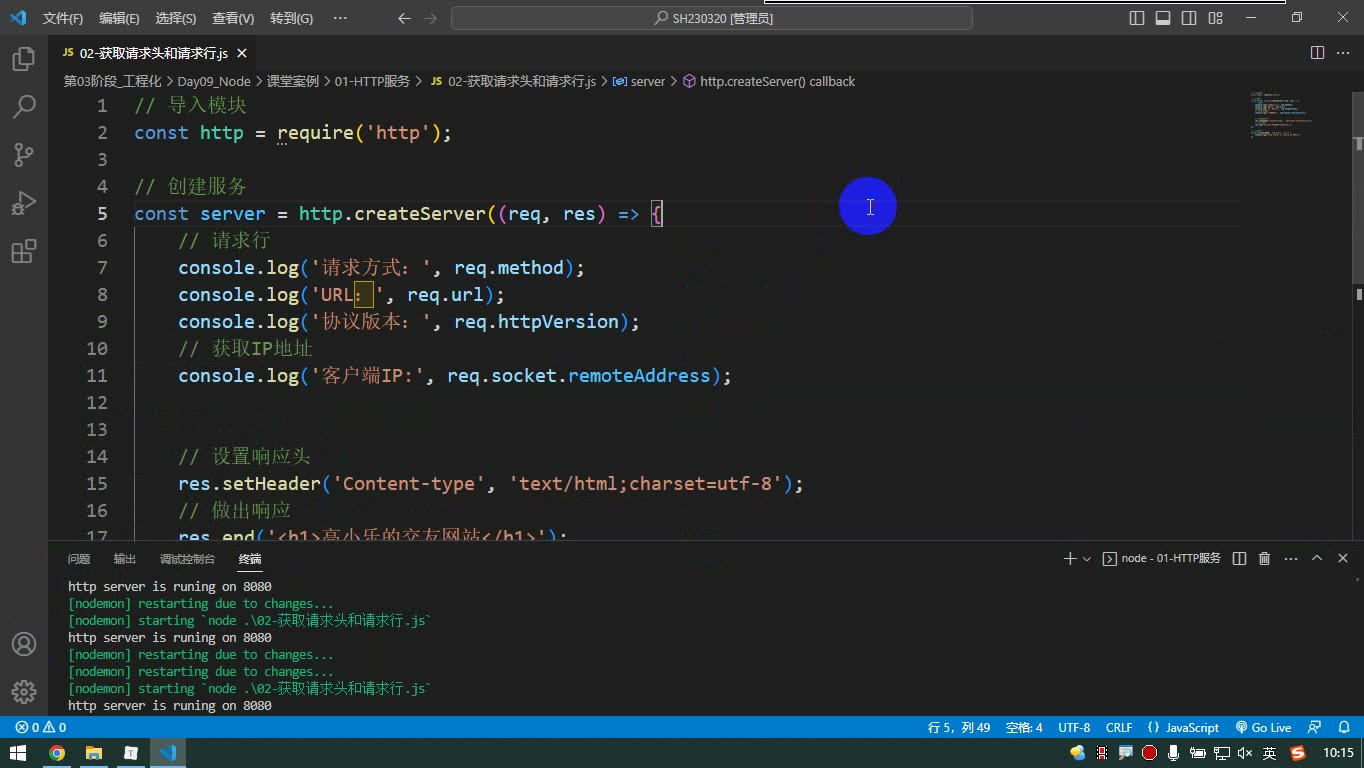
怎么想:请求行信息从 req 取:req.method、req.url、req.httpVersion;请求头从 req.headers 取;客户端 IP 不在请求报文里,而在底层连接信息中,用 req.socket.remoteAddress。
怎么做:
js
const http = require('http');

http.createServer((req, res) => {
  console.log('请求方式', req.method);
  console.log('URL', req.url);
  console.log('协议版本', req.httpVersion);
  console.log('请求头', req.headers);
  console.log('客户端IP', req.socket.remoteAddress);
  res.end('ok');
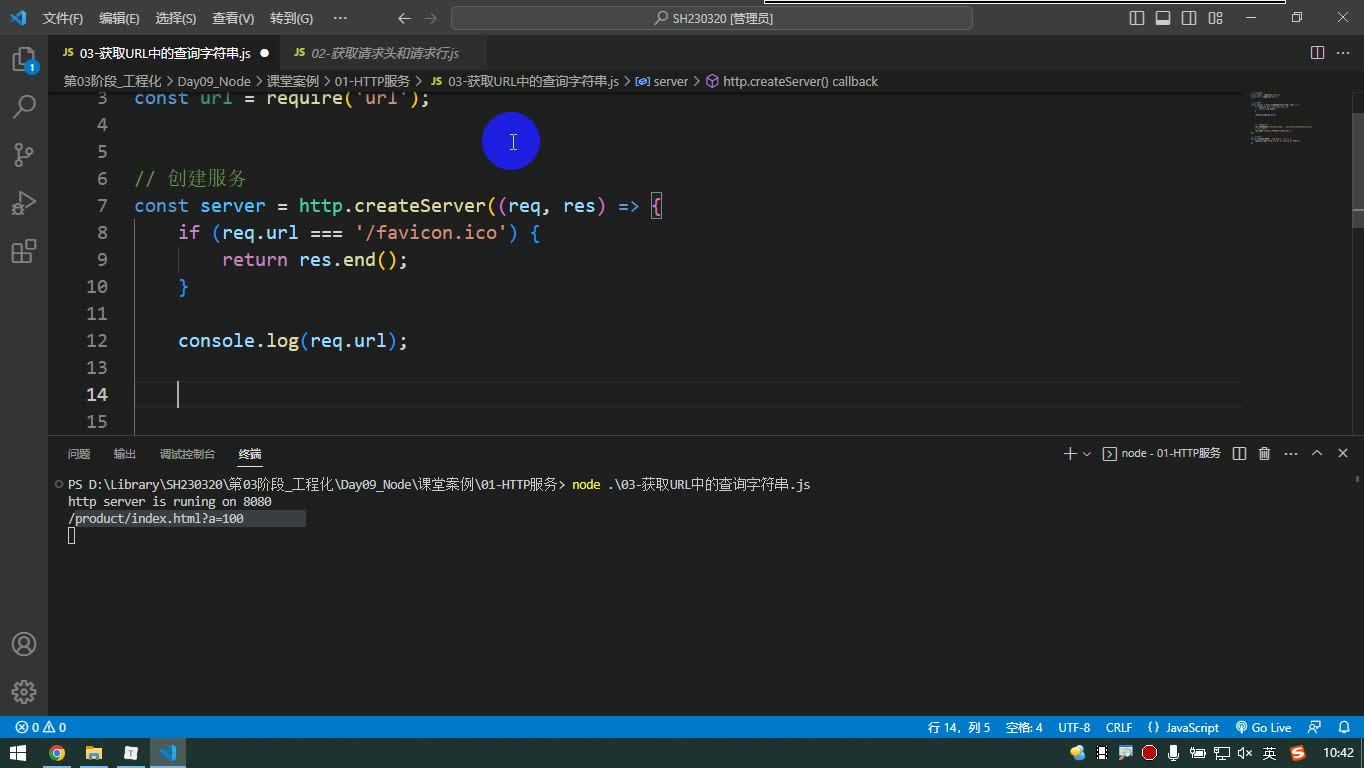
}).listen(8080, () => console.log('running'));易错点:req.headers['user-agent'] 这种带短横线的属性不能用点语法;req.url 只包含路径名和查询字符串,不含协议、主机名、端口号和锚点;想过滤浏览器自动请求的图标,可判断 req.url === '/favicon.ico' 后直接 res.end()。
四、解析查询字符串:url.parse 与 new URL
为什么需要:搜索、分页、表单提交常把信息拼在 URL 查询字符串里,例如 ?wd=暴富&page=1,服务端必须把它拆成可用的数据。
怎么想:req.url 里包含路径名和查询字符串。老办法用 url.parse(req.url, true),第二个参数传 true 会把 query 解析成对象;新办法用 new URL(req.url, 'http://127.0.0.1:8080'),但必须补一个完整的基础 URL,否则会报“无效 URL”。取参数时用 searchParams.get('wd')。
怎么做:
js
const http = require('http');
const url = require('url');

http.createServer((req, res) => {
  const info = url.parse(req.url, true);
  console.log(info.query.wd);

  const info2 = new URL(req.url, 'http://127.0.0.1:8080');
  console.log(info2.searchParams.get('wd'));

  res.end('ok');
}).listen(8080);表单用 GET 提交时,浏览器会把输入框、下拉框的 name 和 value 自动拼成查询字符串;锚点只对浏览器有意义,不会发给后端。
易错点:url.parse 虽被标记弃用但课堂仍在用;searchParams 不是普通对象,不能直接点属性,要用 get;查询字符串不适合携带大量信息;响应中文要设置 charset=utf-8,否则可能乱码。
本节回顾两块最常用的基础:npm 包管理与 HTTP 协议。下面按“为什么需要→怎么想→怎么做→易错点”把笔记串成教程。
一、npm 包管理工具:会装、会删、会看版本
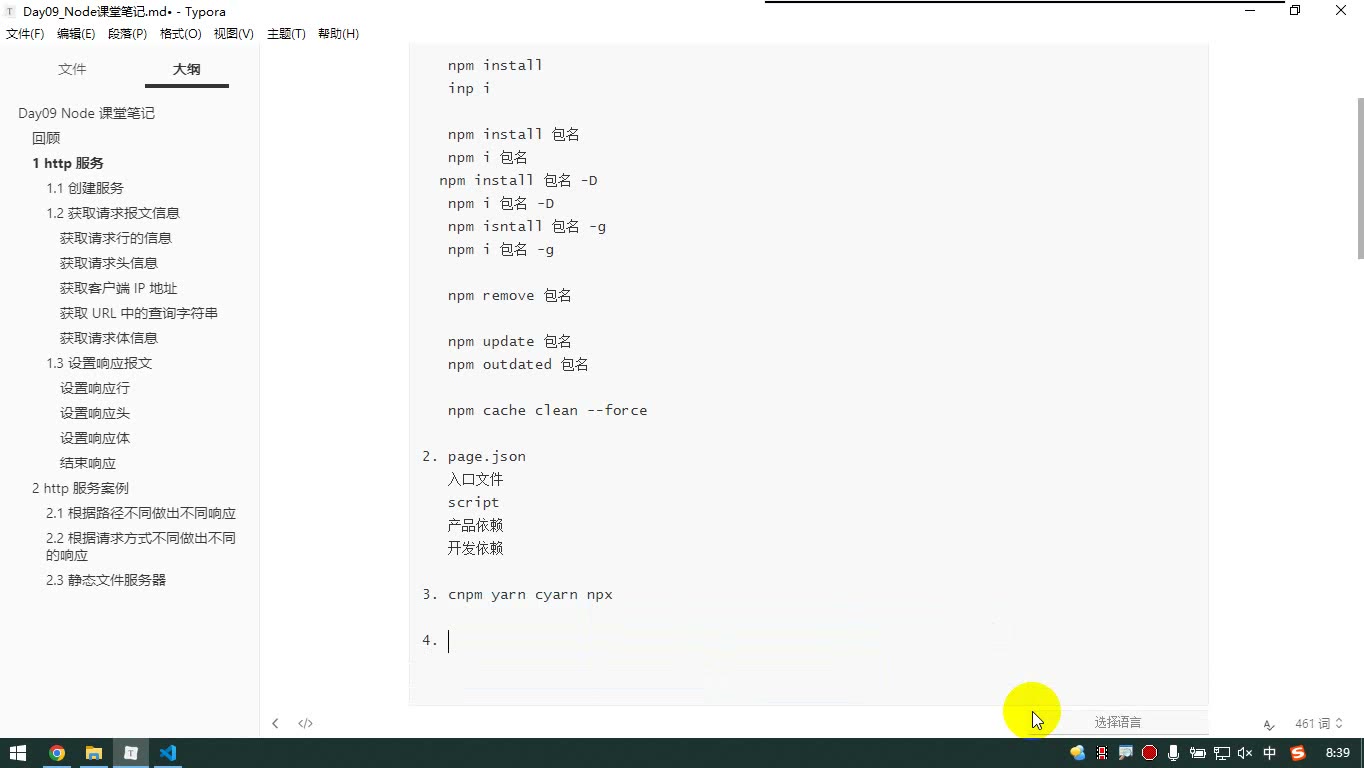
为什么需要:项目要用第三方包,也要和同事同步依赖,不能靠手工拷贝。怎么想:npm 围绕 package.json 工作,安装、删除、更新、查 outdated、清缓存都是围绕依赖版本展开。怎么做:先 npm init 生成项目描述文件;安装全部依赖用 npm install,简写 npm i;装指定包用 npm install 包名 或 npm i 包名;开发依赖加 -D;全局安装加 -g;删除用 npm remove 包名;更新用 npm update 包名;查看哪些包可更新用 npm outdated 包名;更新前可清缓存 npm cache clean --force。课堂演示中,运行 npm install 后依赖会自动写入 package.json;用 npm outdated 能看到“当前版本”和“最新版”。笔记代码保留如下(把同音错字 inp i、isntall 纠正为 npm i、install):
bash
npm init

npm install
npm i

npm install 包名
npm i 包名
npm install 包名 -D
npm i 包名 -D
npm install 包名 -g
npm i 包名 -g

npm remove 包名

npm update 包名
npm outdated 包名

npm cache clean --force易错点:默认 npm install 包名 加到产品依赖,只有 -D 才加到开发依赖;版本号前常见 ^,它锁定大版本,所以 npm update 通常只更新次版本和小版本,不跨大版本;更新前清缓存,避免服务器已更新而本地仍用旧缓存。
二、package.json:入口、脚本与两类依赖
为什么需要:它是项目说明书,别人拿到代码后靠它恢复依赖、执行脚本。怎么想:重点看入口文件 main、命令别名 scripts、产品依赖 dependencies、开发依赖 devDependencies。怎么做:scripts 里配命令别名,用 npm run 执行;产品依赖是项目代码运行时要用的,开发依赖只在开发阶段用。易错点:笔记里写的 page.json 实际是 package.json;不要把所有包都塞进产品依赖,-D 安装的包应出现在开发依赖里。
三、cnpm、yarn、cyarn、npx:替代与补充命令
为什么需要:不同团队可能用不同包管理工具,命令要能看懂。怎么想:它们解决的是安装来源、速度或执行方式问题,不是新协议。怎么做:知道 cnpm、yarn、cyarn 可作 npm 的替代命令,npx 可直接执行包命令。易错点:不要混用后以为依赖一定写进同一份锁文件;团队统一工具最重要。
四、网络协议基础:IP、域名、端口号、URL
为什么需要:浏览器要找到服务器上的某个程序,再定位具体资源。怎么想:IP 定位电脑,域名是 IP 的别名;端口号定位电脑上的程序;URL 定位资源。怎么做:URL 可拆成协议、主机名、路径、文件名、查询字符串、锚点。易错点:只有 IP 只能找到电脑,找不到具体服务,所以 HTTP 服务要监听端口;端口号是程序级概念,不是电脑级概念。
五、HTTP 请求报文:客户端发给服务器
为什么需要:浏览器要把“我要什么”告诉服务器。怎么想:请求报文四部分——请求行、请求头、空行、请求体。怎么做:请求行含请求方式、URL、协议版本;请求头是键值对;空行分隔;请求体是客户端发给服务端的数据,浏览器调试面板里常叫“载荷”。课堂调试时可在 Network 面板直接看请求报文。易错点:请求行不是请求头;请求头里常见 User-Agent 等标准头;请求体不一定每次都有。笔记结构保留:
text
请求行	请求方式、URL、协议版本
请求头  键值对
空行
请求体 载荷六、HTTP 响应报文:服务器回给客户端
为什么需要:服务器要告诉浏览器结果和内容。怎么想:响应报文也是四部分——响应行、响应头、空行、响应体。怎么做:响应行含响应状态码、状态描述、协议版本;响应头是键值对;空行分隔;响应体是给客户端的内容。转写稿举例:200 表示成功,304 常表示用缓存,404 表示资源不存在,403 表示无权限,5xx 表示服务器错误。易错点:状态描述通常与状态码对应;响应体可能是 HTML/CSS 等具体内容;调试时不要只看页面,要回到 Network 看响应报文。笔记结构保留:
text
响应行	响应状态码 响应状态描述 协议版本
响应头  键值对
空行
响应体 给客户端的内容把这两块连起来看:npm 管的是项目依赖,HTTP 管的是客户端与服务器之间“请求—响应”的通信格式。命令用熟、报文结构看清,后面写 Node 服务时就不容易乱。
从“写脚本”到“写服务”:HTTP 服务是什么
为什么需要:前面用 Node 处理文件、目录,程序执行完就结束;后端服务不同,它要长期运行,等客户端发请求,再返回响应。
怎么想:服务器首先是一台电脑,电脑上运行“HTTP 服务程序”;客户端电脑上的浏览器发请求,服务程序接收请求并作出响应。服务器只是角色,不等于高配机器;开发时同一台电脑既当服务器又当客户端,用 127.0.0.1 或 localhost 自己访问自己。
怎么做:用 Node 内置 http 模块创建服务并监听端口。端口用来区分同一台电脑上的不同程序。
易错点:服务启动后不会像普通脚本那样立刻结束;修改代码后要先 Ctrl+C 结束旧进程,再重新启动。
创建服务与启动服务
为什么需要:只有创建服务对象还不够,必须监听端口,浏览器才知道把请求发给哪个程序。
怎么想:http.createServer 接收一个回调函数,这个回调不是创建时执行,而是“接收到请求时”执行;回调能拿到请求对象 req 和响应对象 res。
怎么做:
js
const http = require('http');

const server = http.createServer((req, res) => {
  console.log('接收到一个请求');
  res.setHeader('Content-Type', 'text/html; charset=utf-8');
  res.end('<h1>Welcome to my website</h1>');
});

server.listen(8080, () => {
  console.log('HTTP server is running on 8080');
});易错点:不调用 res.end() 响应不会结束;不调用 listen 服务不会真正启动;回调里的 req/res 是形参名,可以换名,但语义分别是请求和响应。
请求报文、响应报文与调试
为什么需要:理解报文结构,才能知道 req.method、req.url、req.headers 从哪里来。
怎么想:请求报文由客户端发给服务器,包含请求行、请求头、空行、请求体;响应报文由服务器发给客户端,包含响应行、响应头、空行、响应体。请求行有请求方式、URL、HTTP 版本;响应行有状态码、状态描述、协议版本。
怎么做:常见状态码要记住:200 成功,304 缓存,404 资源不存在,403 无权限,500 服务器错误,503 服务不可用。调试时打开浏览器“网络”面板看请求和响应。
易错点:浏览器地址栏回车发起的是 GET 请求;刷新时可能看到两次请求,其中一次是浏览器自动请求 /favicon.ico,不是你的代码重复执行。可这样规避:
js
if (req.url === '/favicon.ico') {
  res.end();
  return;
}获取请求行、请求头与客户端 IP
为什么需要:后端要根据请求方式、路径、请求头判断客户端要什么。
怎么想:请求行信息从 req 上取;请求头是对象;客户端 IP 不在请求报文里,而在底层 socket 连接信息中。
怎么做:
js
const http = require('http');

const server = http.createServer((req, res) => {
  console.log('请求方式', req.method);
  console.log('URL', req.url);
  console.log('协议版本', req.httpVersion);
  console.log('请求头', req.headers);
  console.log('浏览器信息', req.headers['user-agent']);
  console.log('客户端IP', req.socket.remoteAddress);
  res.end('ok');
});

server.listen(8080, () => {
  console.log('running on 8080');
});易错点:user-agent 带短横线,不能写 req.headers.user-agent,要用中括号:req.headers['user-agent']。
URL 与查询字符串
为什么需要:搜索、分页等常把信息放在查询字符串里,例如 ?wd=hello&page=1。
怎么想:req.url 只包含路径名和查询字符串,不包含协议、主机名、端口号,也不包含锚点。解析查询字符串有两种常见方式。
怎么做:
js
const url = require('url');

const info = url.parse(req.url, true);
console.log(info.query); // { wd: 'hello', page: '1' }也可用新 API:
js
const { searchParams } = new URL('http://127.0.0.1' + req.url);
console.log(searchParams.get('wd'));
console.log(searchParams.get('page'));易错点:new URL(req.url) 会报“URL 无效”,因为 req.url 不完整,需要临时拼上协议和主机名;URLSearchParams 取参数要用 get(),不能直接点属性。url.parse 虽已弃用,但老项目仍常见。
常见错误与开发提效
为什么需要:HTTP 服务开发中会反复改代码,也会遇到端口被占用。
怎么想:端口冲突常见报错是 EADDRINUSE,表示地址已被使用;开发时可用 nodemon 自动重启。
怎么做:先 Ctrl+C 结束旧服务,再运行;或用 nodemon 01-http.js。端口被占用时可换端口,或找到占用进程结束它。监听 80 时浏览器地址可省略端口;监听 8080 时地址后必须写 :8080。listen 第二参数可限制 IP,一般开发不必设置。
易错点:不要随意杀进程,可能影响系统;localhost 与 127.0.0.1 都表示本机;服务已启动时再启动一次同一端口,会直接报端口占用。
课堂画面
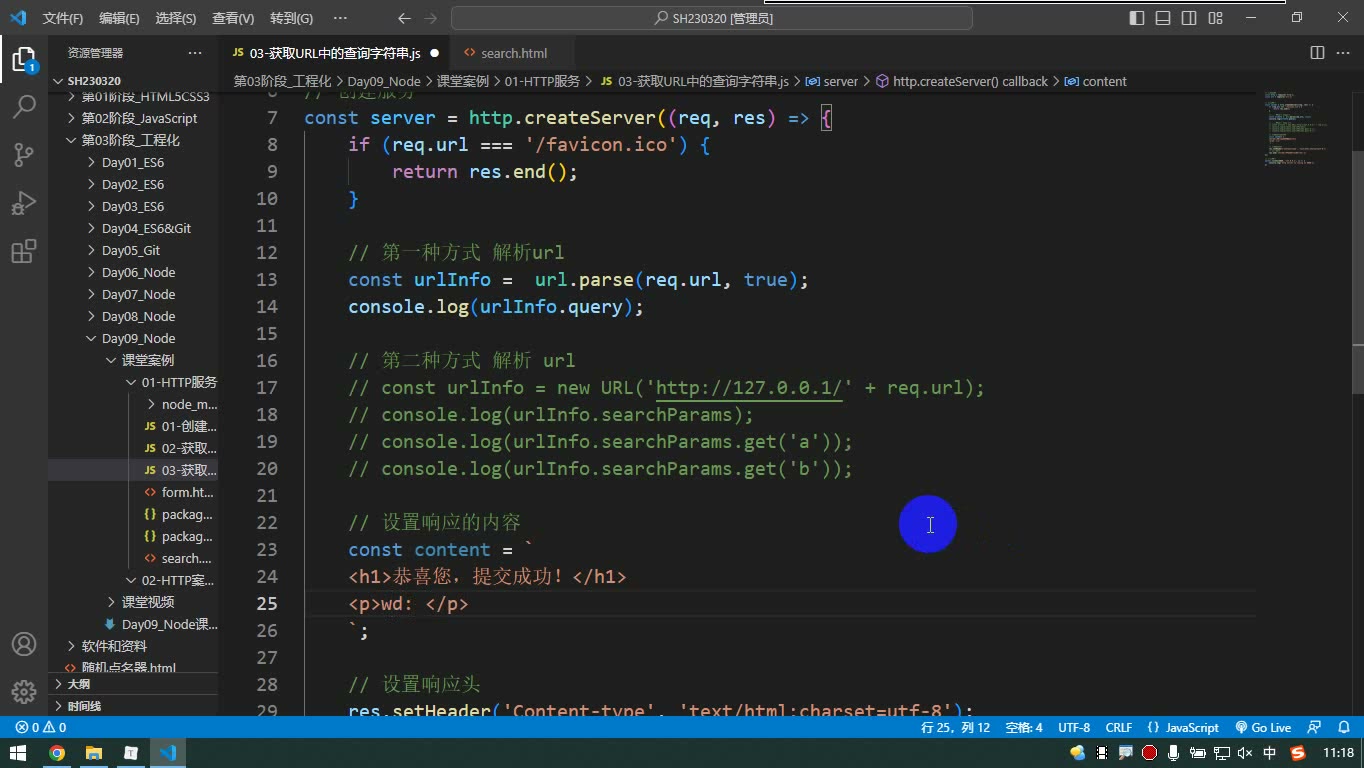
代码示例
示例 1:创建 HTTP 服务(01-创建HTTP服务.js)
js
// 01-创建HTTP服务.js
// 1. 导入内置模块 http —— 内置模块不需要 npm 安装
const http = require('http');

// 2. 创建服务对象:参数是回调函数,收到请求时自动执行
const server = http.createServer(function (req, res) {
  // req:请求对象,能拿到客户端发来的请求报文信息
  // res:响应对象,负责给客户端回响应
  console.log('接收到一个请求');

  // 客户端 IP 不在请求报文里,来自底层 TCP 连接
  console.log('客户端 IP:', req.socket.remoteAddress);

  // 设置响应头,解决中文乱码
  res.setHeader('content-type', 'text/html; charset=utf-8');

  // end() 结束响应并返回内容,浏览器会解析其中的 HTML
  res.end('<h1>welcome to my website</h1>');
});

// 3. 启动服务,监听端口
server.listen(8080, function () {
  console.log('HTTP server is running on 8080');
});关键行 / 易错点
http.createServer(回调)的回调函数不是立即执行,而是在接收到请求时自动执行;listen的回调才是服务启动成功时立即执行。- 回调的两个形参名可以随意取,习惯叫
req(request,请求对象)和res(response,响应对象);请求报文相关的一切都从req取,回响应都走res。 res.end()既结束响应又能带内容,写完就不要再往下写;响应 HTML 时浏览器会正常解析,<h1>会又黑又粗又大。- 不设置
content-type: text/html; charset=utf-8时,中文一定乱码。 - 这个程序不会自动结束(一直监听端口),改代码后必须先
Ctrl + C结束再重新node启动,开发时可用nodemon 01-创建HTTP服务.js自动重启。 - 端口被别人(常常是自己上一次没关掉的进程)占用会报
EADDRINUSE,换端口或杀掉占用端口的进程即可。 - 监听 80 端口时浏览器地址栏可省略端口号;
127.0.0.1和localhost是一个意思,都表示本机。 - 浏览器会“背着我们”多发一个
/favicon.ico请求,所以刷新一次控制台常输出两次。
示例 2:获取请求行和请求头(02-获取请求行和请求头.js)
js
// 02-获取请求行和请求头.js
const http = require('http');
const { table } = require('table'); // 先 npm i table

const server = http.createServer(function (req, res) {
  res.setHeader('content-type', 'text/html; charset=utf-8');

  // 浏览器自动请求的网站标题栏图标,直接结束掉,避免干扰
  if (req.url === '/favicon.ico') {
    res.end();
    return; // 后面的代码不再执行
  }

  // 请求行三部分
  console.log('请求方式:', req.method);
  console.log('URL:', req.url);
  console.log('协议版本:', req.httpVersion);

  // 请求头是一个对象
  console.log(req.headers);
  // 带短横线的属性名不能点,要用中括号
  console.log('客户端浏览器信息:', req.headers['user-agent']);

  // 把对象转成二维数组,再用 table 打印成表格
  console.log(table(Object.entries(req.headers)));

  res.end('<h1>高小乐的交友网站</h1>');
});

server.listen(8080, function () {
  console.log('HTTP server is running on 8080');
});关键行 / 易错点
- 请求行三件套:
req.method(请求方式)、req.url(URL)、req.httpVersion(协议版本);从地址栏敲回车发出的请求一定是 GET。 req.url只包含 pathname + 查询字符串,不含协议、主机名、端口号,锚点(#后面)也不会发给服务器,所以默认访问就是/。req.headers是对象,user-agent这类带短横线的属性名不能用点,必须req.headers['user-agent'],否则语法就不对。table包需要npm i table;它导出的对象里才有table方法,所以用解构const { table } = require('table')(不解构就得写table.table(...))。table()要的是二维数组,req.headers是对象,必须先Object.entries()转成[[键, 值], ...]才能打印成表格。- 过滤
favicon.ico时res.end()后一定要return,否则后面还会继续执行一次响应,报错 “write after end”。 - 客户端 IP 用
req.socket.remoteAddress获取,它不在请求报文里,是从底层 TCP 连接拿到的。
示例 3:获取 URL 中的查询字符串(03-获取查询字符串.js + search.html)
js
// 03-获取查询字符串.js
const http = require('http');
const url = require('url');

const server = http.createServer(function (req, res) {
  res.setHeader('content-type', 'text/html; charset=utf-8');

  // 方式一:url.parse 第二个参数传 true,query 直接就是对象
  const urlInfo = url.parse('http://127.0.0.1' + req.url, true);

  // 方式二:new URL(),必须传完整 URL,否则报 Invalid URL
  // const urlInfo2 = new URL('http://127.0.0.1' + req.url);
  // console.log(urlInfo2.searchParams.get('wd'));

  const content = `<h1>恭喜你提交成功</h1>
    <p>wd: ${urlInfo.query.wd}</p>
    <p>type: ${urlInfo.query.type}</p>
    <p>origin: ${urlInfo.query.origin}</p>`;

  res.end(content);
});

server.listen(8080, function () {
  console.log('HTTP server is running on 8080');
});html
<!-- search.html -->
<form action="http://127.0.0.1:8080">
  <input type="text" name="wd">
  <select name="type">
    <option value="1">网页</option>
    <option value="2">图片</option>
    <option value="3">资讯</option>
  </select>
  <select name="origin">
    <option value="baidu">百度</option>
    <option value="360">360</option>
    <option value="sogou">搜狗</option>
  </select>
  <button>搜索</button>
</form>关键行 / 易错点
url.parse(req.url, true)的第二个参数true是把查询字符串直接解析成对象的开关,不加它query只是一串字符串,还得自己再拆。req.url不完整(缺协议和主机名),new URL(req.url)会直接报Invalid URL;所以要手动拼一个'http://127.0.0.1' + req.url,拼什么主机名都不影响解析结果。url.parse虽已被标记弃用,但仍能正常使用且最省事;new URL()的searchParams是类 Map 结构,不能点属性,必须searchParams.get('wd')。- 表单默认就是 GET,提交时浏览器会自动把控件拼成
?wd=xxx&type=1&origin=baidu;没有name的控件不会提交,value才是拼进查询字符串的值(下拉框选中项看value,不看显示文字)。 - 表单
action的端口必须和服务listen的端口一致(写成 8090 而服务在 8080,请求就发不到服务上)。 - 改完代码记得重启服务(或直接用
nodemon),否则页面表现和代码对不上;查询字符串不适合携带大量数据,锚点也不会出现在req.url里。
常见错误
1. 改了代码,刷新浏览器还是旧内容
- 现象:控制台加了
console.log或改了响应文字,浏览器刷新后毫无变化,日志也不打印。 - 原因:HTTP 服务进程一直在运行,加载的是启动那一刻的代码;不
Ctrl+C结束进程,改动不会生效。 - 修法:先
Ctrl+C停掉,再重新node 文件;开发期直接用nodemon 文件启动,保存即自动重启。
2. 启动报 EADDRINUSE: address already in use :::8080
- 现象:服务起不来,终端抛端口被占用错误。
- 原因:同一端口上已有一个进程在监听(最常见就是自己在另一个终端里已经跑过一遍)。
- 修法:关掉多余终端里的进程,或换个端口(如 8081);确实找不到占用者时,
netstat -ano | findstr 8080拿到 PID 后在任务管理器结束,Linux/macOS 用kill -9 PID。
3. 只运行了文件、没发请求,却奇怪回调里的日志没打印
- 现象:
node 01.js后终端只出现 "server is running",createServer回调里的内容一条都没有。 - 原因:把
createServer的回调当成了启动时执行,实际它要等收到请求才触发;启动成功的日志来自listen的回调,两者不是一回事。 - 修法:用浏览器访问对应地址制造一次请求再看日志;排查时先确认访问的 IP、端口与服务端
listen的一致。
4. 响应中文变成乱码
- 现象:浏览器显示
欢è¿之类,终端里中文正常。 - 原因:响应头没有声明编码,浏览器按默认编码解析响应体。
- 修法:
res.setHeader('Content-Type', 'text/html; charset=utf-8'),且必须写在res.end()之前。
5. 刷新一次页面,服务端日志却打印两遍
- 现象:明明只按了一次 F5,回调执行了两次。
- 原因:浏览器自动额外请求了
/favicon.ico,不是自己发的请求。 - 修法:在回调开头判断
req.url === '/favicon.ico'时直接res.end()并return,避免后续逻辑重复执行。
6. new URL(req.url) 抛 Invalid URL
- 现象:用 URL 类解析请求地址时直接报错中断。
- 原因:
req.url只包含路径名和查询字符串,缺少协议和主机名,不是完整 URL。 - 修法:拼接后再解析,如
new URL('http://127.0.0.1' + req.url);前缀内容不影响解析结果。
7. 取 user-agent 写成 req.headers.user-agent
- 现象:取到
undefined,甚至语法报错。 - 原因:属性名含短横线,不符合标识符规范,不能点取。
- 修法:
req.headers['user-agent']。
8. 让同学访问,对方却打不开
- 现象:自己
127.0.0.1:8080正常,别人用同样地址访问失败。 - 原因:
127.0.0.1/localhost是回环地址,只指向访问者自己的机器;且listen第二参数若限定了127.0.0.1,其他 IP 也进不来。 - 修法:让对方用本机的局域网 IP(
ipconfig查看);服务端不要写死127.0.0.1作为监听地址。
练习
1. 端口与访问路径排查 启动一个监听 8080 的服务,分别用 http://127.0.0.1:8080、http://localhost:8080、http://127.0.0.1 访问,记录哪些能通、哪些不能,并说明原因。再把端口改成 80 重做一次。
2. 请求信息面板 写一个服务:收到请求后,把请求方式、req.url、HTTP 版本、客户端 IP、user-agent 以表格形式打印在终端(可用 Object.entries + table 包),浏览器只返回一句"已收到"。
3. 简易路由 用 req.url 做分支:/ 返回首页 HTML(含中文,注意编码),/about 返回一段文字,/favicon.ico 返回空并 return,其余路径返回 404 状态码与提示。要求用状态码体现差异,而不是只改文字。
4. 查询参数计算器 用 URL 类解析查询字符串,支持 ?a=10&b=20 时响应 a + b = 30;参数缺失或非数字时响应明确错误提示。再用表单或地址栏各提交一次验证。
5. 组合练习:表单回显 自己写一个含文本框、下拉框的 HTML 表单,提交到你的服务;服务端解析查询字符串后,把每个字段名和值以列表形式回显到页面上。要求下拉框的 name 与 value 都由你设计,并说明它们最终出现在请求的哪个位置。
原视频对照
| # | 视频 | 时长 |
|---|---|---|
| 1 | 总结npm和http协议 | 14:27 |
| 2 | 创建http服务 | 52:33 |
| 3 | 获取请求行和请求头信息 | 25:15 |
| 4 | 获取URL中的查询字符串 | 27:08 |
| 5 | 获取URL中的查询字符串02 | 06:00 |
小结
- 创建服务(
createServer)和启动服务(listen)是两步,缺一不可;createServer的回调由请求驱动,listen的回调由启动成功驱动。 - 服务进程是常驻的,代码变更必须重启才生效,
nodemon是开发期的标准配置。 - 端口是"程序"的身份标识,IP 只能定位到机器;两者结合才能定位到具体服务,因此地址里少写端口通常意味着访问了别的东西。
127.0.0.1与localhost等价且仅限本机,跨机器访问必须使用局域网/公网 IP。- 一次页面刷新不等于一次请求,浏览器会自作主张地发额外请求,写服务端逻辑时要按
req.url做分流并及早return。 req.url是不完整 URL,只含路径名和查询字符串;锚点不会到达服务端,查询字符串才是前后端传参的常规通道。- 查询字符串解析有
querystring.parse与URL类两条路,前者能直接出对象但已废弃,后者是官方推荐但要拼完整地址、取值走searchParams.get()。 - 响应头决定浏览器如何解读响应体,编码、内容类型这类问题一律优先怀疑响应头,而不是数据本身。