主题
异常处理语法与JSON 数据格式以及处理(Day7 2/3)
本页对应 Day07_Node,共 6 段视频,约 1 小时 12 分。
学习目标
- 能够使用
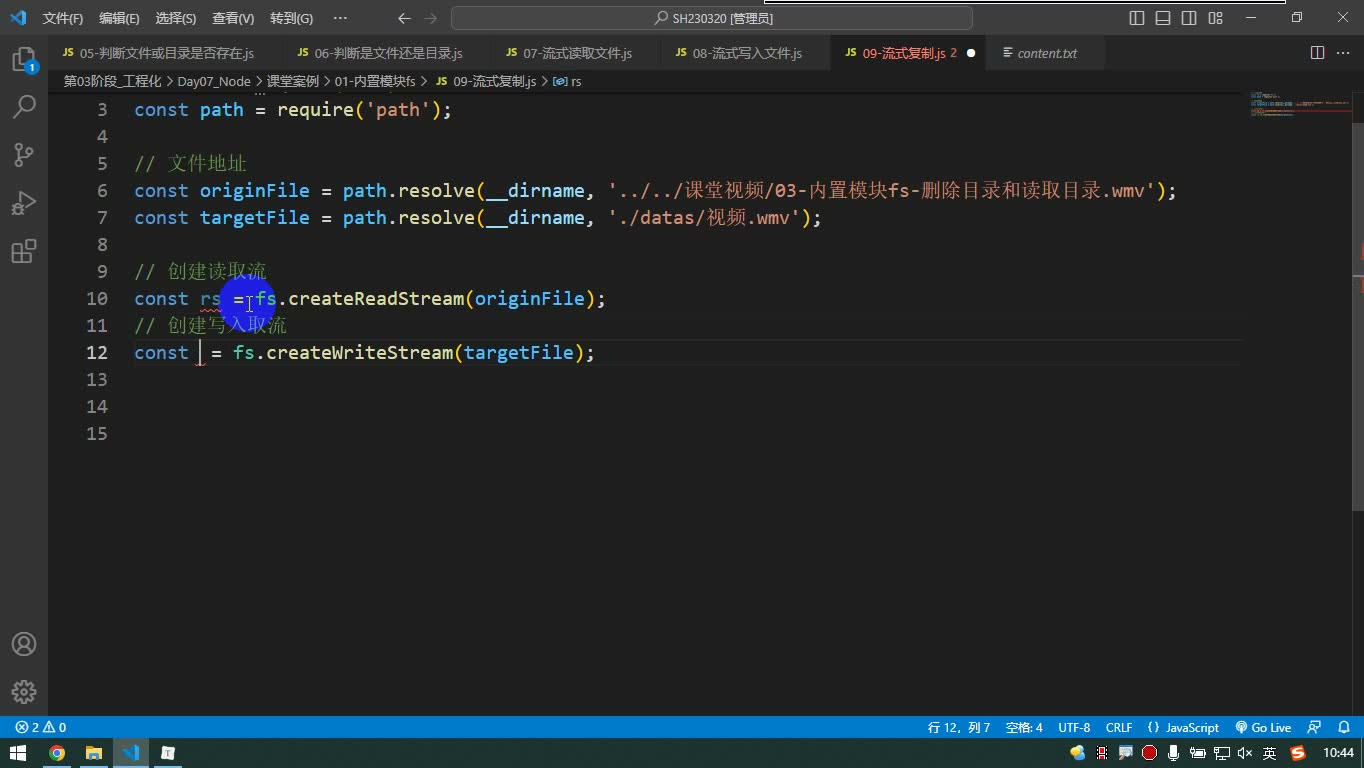
fs.createReadStream与fs.createWriteStream完成大文件流式复制,并能说明pipe管道复制的作用与优势。 - 能够使用
url模块解析网址,区分url.parse与new URL的返回结果,并提取协议、主机名、端口、路径、查询字符串、锚点等组成部分。 - 能够使用
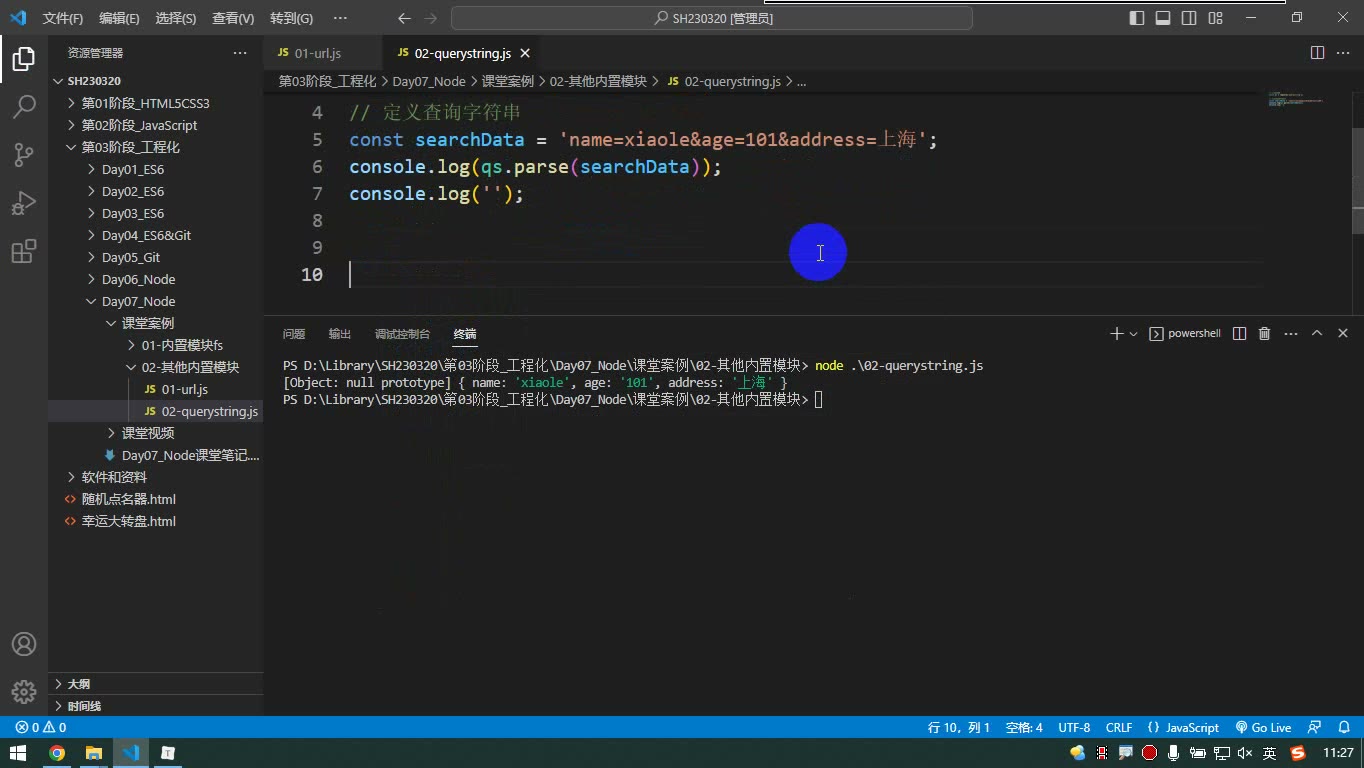
querystring模块完成查询字符串与对象之间的相互转换,并说明其与 URL 查询参数解析的关系。 - 能够使用
Error、throw、try...catch编写异常处理代码,区分系统错误与主动抛出错误,并验证捕获后不影响后续代码执行。 - 能够使用
JSON.parse与JSON.stringify完成 JSON 字符串与对象/数组的相互转换,并结合fs读写 JSON 文件。 - 能够区分 CommonJS 与 ES Module 模块规范,使用
require/module.exports创建并导入自定义模块,说明内置模块、自定义模块、第三方模块的区别。
知识点
先认识错误对象:错误也是对象
为什么需要:代码一旦出错,系统会抛出一个错误。我们需要知道错误信息、错误编号,才能定位和处理问题。Node 文档里能查到 Error 错误对象,它带有 message、code、errno 等属性。系统报错时抛的是错误对象,我们自己也可以创建错误对象。
怎么想:不要把“报错”只当成终端里的一行红字。错误本身是一个对象,new Error('错误信息') 得到的就是错误对象;真正取错误说明时,常用 err.message。
怎么做:
js
const err = new Error('小乐 is not defined');

console.log(err);
console.log(err.message);运行后可以看到错误对象;把 console.log(err) 注释掉,只输出 err.message,看到的就是错误信息。转写稿里还提到:错误对象除了 message,还可能有 code、errno 等属性,但不是每个错误都一定有。
易错点:new Error() 只是创建错误对象,不等于主动抛出;直接输出整个错误对象和取 err.message 不是一回事;不要默认 errno 一定存在。
主动抛出错误:throw
为什么需要:有些情况代码本身没崩,但业务上不允许继续,比如参数不对、状态不满足。这时要主动中断,把错误抛给系统处理。
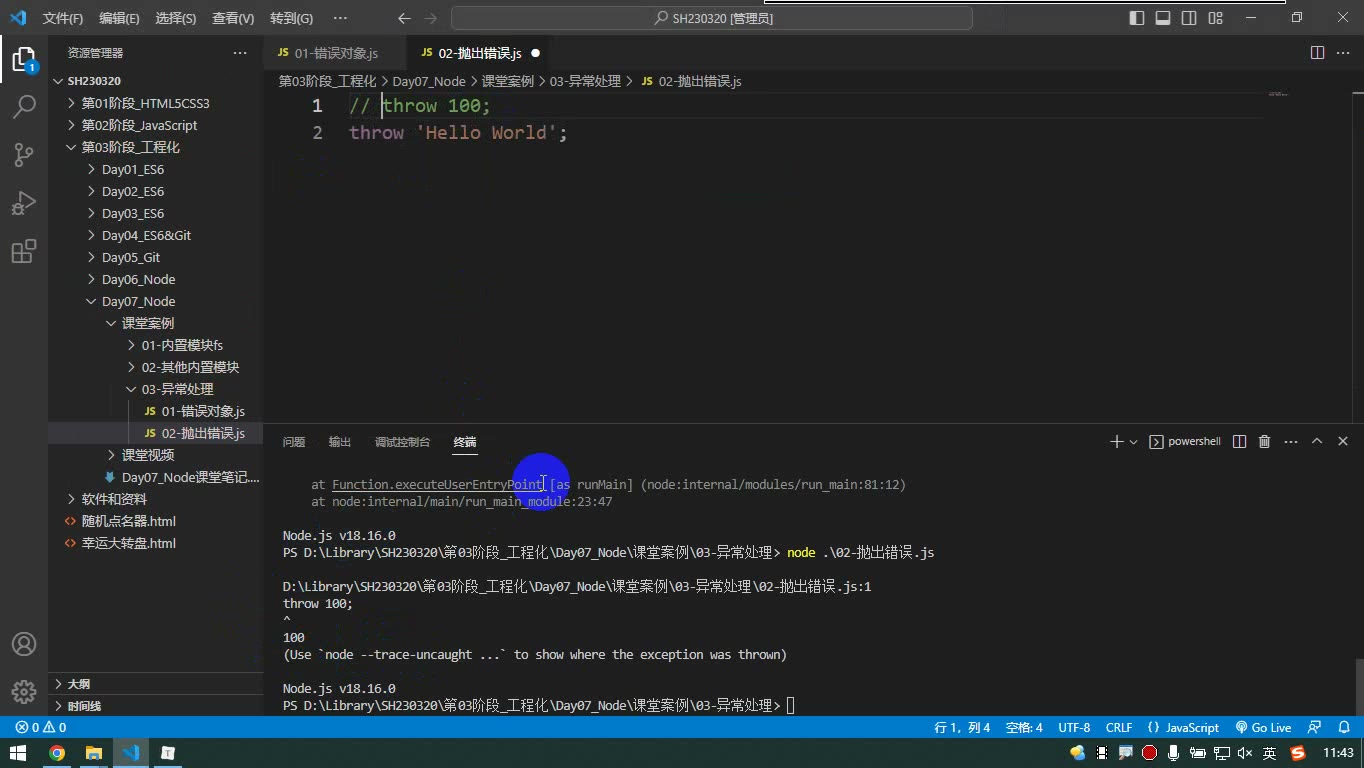
怎么想:throw 后面的代码不会再执行,因为错误已经抛出,程序会中断。throw 后面可以跟数字、字符串,也可以跟错误对象;但最正经的写法是抛 Error 对象,因为它有错误信息,形态也接近系统报错。
怎么做:
js
// throw 100;
// throw '出错了';
throw new Error('getInfo is not defined');转写稿里演示了三种写法:throw 100、throw '字符串'、throw new Error(...)。前两种也能抛,但不推荐作为正式错误;推荐 throw new Error('...')。
文档里 fs.readFile 的案例也有类似写法:
js
fs.readFile(path, (err, data) => {
  if (err) {
    throw err;
  }
  // ...
});这里的 throw err 就是把回调里的错误对象继续抛出。
易错点:throw 后同层后续语句不执行;不要抛字符串当正式错误;文档里的 throw err 是抛错误对象,不是打印错误。
try...catch:把错误影响缩小
为什么需要:如果不捕获,错误会让程序中断,后面的代码也没法执行。try...catch 的作用是:try 里的代码一旦抛错,不直接报给系统,而是被 catch 捕获,交给程序员处理。
怎么想:把“不稳定、说不准什么时候出错”的代码放进 try,比如网络相关、文件相关操作。catch 接收到的参数就是错误对象。捕获后可以输出信息,也可以选择“当看不见”,关键是别让错误影响外面。
怎么做:
js
try {
  // 调用不存在的函数,属于系统报错
  getInfo();

  console.log('try 内部错误之后的代码');
} catch (err) {
  console.log('捕获到:', err.message);
  console.log('错误编号:', err.errno);
}

console.log('catch 后面的代码继续执行');也可以主动抛错:
js
try {
  throw new Error('小乐 is not defined');
} catch (err) {
  console.log(err.message);
}

console.log('后面的代码继续执行');调试时重点观察两件事:第一,try 内部一旦出错,错误后面的 console.log('try 内部错误之后的代码') 不会执行;第二,catch 后面的 console.log('catch 后面的代码继续执行') 会执行。这就是“把错误影响限制在最小范围”。
易错点:catch 的参数是错误对象,不要写成没有参数还硬取 message;try 范围不要过大,否则不好定位;捕获后不要随便吞掉错误,至少要输出 err.message;本节演示的是同步代码,异步回调里的错误要先看回调的 err 参数,不能想当然认为外层 try 一定能包住。
调试过程:先看报错,再决定捕获
转写稿里的调试思路很清楚:先写 throw new Error(...) 运行,看到程序中断;再把主动抛错注释掉,换成调用不存在的函数,观察系统报错;最后把代码放进 try...catch,看 catch 是否输出 err.message、err.errno,并确认 catch 后面的语句是否继续执行。这样就能分清“系统报错”和“主动抛出”在 try...catch 里都会被捕获,但 try 内部错误后的语句不会执行,catch 后面的代码会继续执行。
JSON 是什么,为什么需要它
JSON 是一种静态数据格式,转写稿里明确说它主要支持两种写法:对象格式用大括号,数组格式用中括号。对象里的属性名必须用双引号包起来,值可以是数字、字符串、数组等;字符串也必须加引号。它不能写函数,也不能写 1 + 2 这种表达式,只能写静态数据。
为什么需要 JSON?因为程序运行时的对象、数组在内存里,程序结束就没了;而 JSON 可以把数据写成固定格式存到文件里,也可以传给其他程序。等需要时再读回来恢复成对象或数组。这就是“对象 → JSON 字符串 → 文件 → JSON 字符串 → 对象”的闭环。
怎么想?先别急着写 Node 代码,先保证 JSON 文件本身合法。怎么做?例如:
json
{
  "name": "小乐",
  "age": 101,
  "children": ["司马姥姥", "欧阳姥姥", "东方姥姥"],
  "address": "上海"
}数组格式也常见,例如:
json
[
  { "name": "曹操", "age": 45, "job": "丞相" },
  { "name": "曹丕", "age": 25, "job": "丞相的大儿子" },
  { "name": "曹植", "age": 24, "job": "四儿子" }
]易错点:属性名不用双引号、字符串用单引号、值里写函数或表达式,都会导致 JSON 不合法。转写稿特别强调“必须是双引号,单引号不好使”。
用 Node 读取 JSON 文件:先拿到字符串
为什么需要先读文件?因为 JSON 数据放在 .json 文件里,Node 要用 fs 读出来。怎么想?读取文件默认得到的是 Buffer,不是对象,也不是普通字符串;要加编码 utf8 才变成字符串。
怎么做?
js
const fs = require('fs');
const path = require('path');

const filePath = path.resolve(__dirname, 'day01.json');

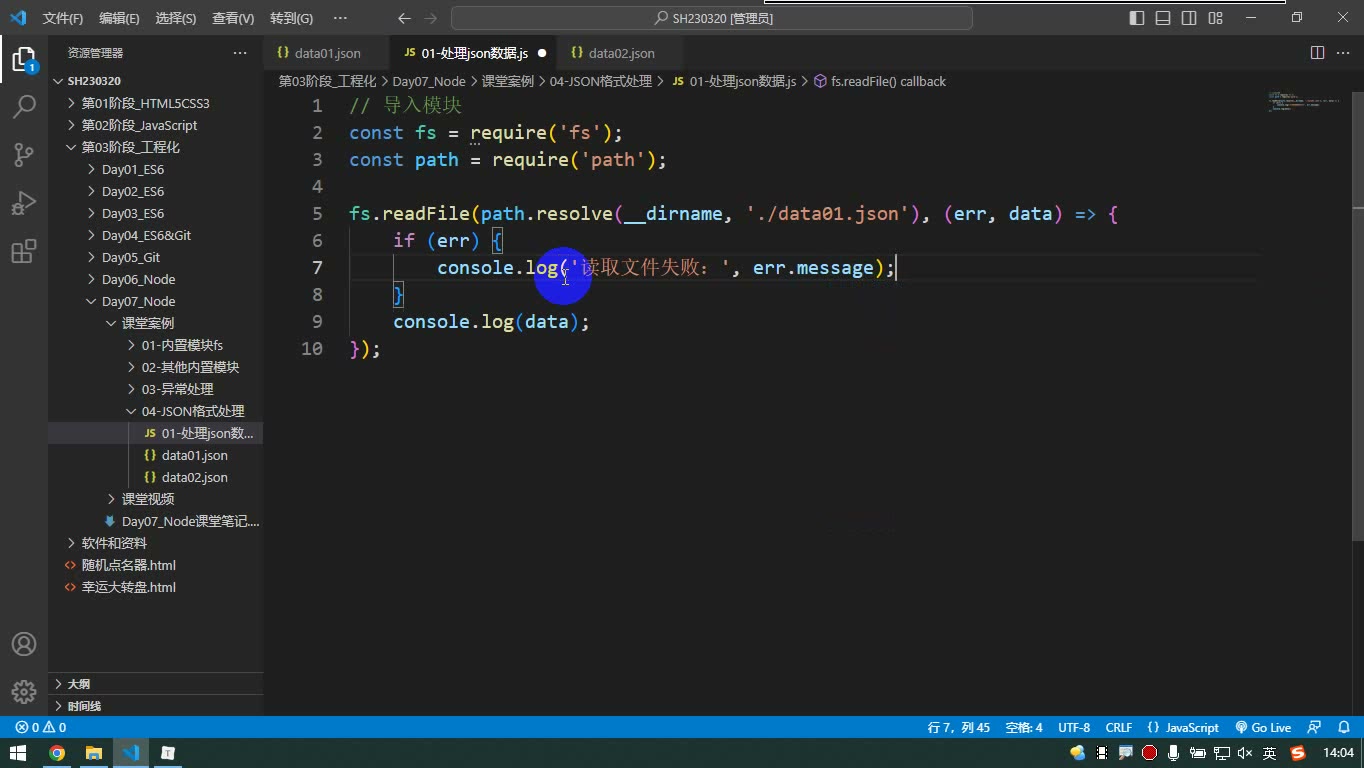
fs.readFile(filePath, 'utf8', (err, data) => {
  if (err) {
    console.log('读取文件失败', err.message);
    return;
  }
  console.log(data); // 此时 data 是字符串
});转写稿里的调试过程很典型:一开始 data 是 Buffer,输出后看不出对象结构;设置 'utf8' 后才变成字符串。这里要纠正几个同音字:不是“板分/8分”,是 Buffer;不是“字母扣/自助串”,是“字符串”。
易错点:路径不要手拼错,转写稿用 path.resolve(__dirname, ...);回调里先判断 err;readFile 的编码参数别漏。
把 JSON 字符串解析成对象或数组
为什么需要 JSON.parse?因为读出来的是字符串,字符串不能直接点属性取数据。怎么想?JSON 字符串格式固定,所以可以用 JSON.parse 解析成 JS 对象或数组。转写稿说 JSON 是内置对象,不是内置模块,不需要 require,和 Buffer、Array 一样属于语言能力。
怎么做?
js
fs.readFile(filePath, 'utf8', (err, data) => {
  if (err) {
    console.log('读取文件失败', err.message);
    return;
  }

  const users = JSON.parse(data);
  console.log(users);

  users.forEach(user => {
    console.log(user.name, user.age);
  });
});如果文件是数组格式,JSON.parse(data) 得到的就是数组,可以直接 forEach 遍历;如果是对象格式,就得到对象,可以点属性取值。转写稿中还出现变量名写错导致报错的调试过程,这提醒我们:解析成功后变量名要写对,别把 users 写成 user 之类。
易错点:JSON.parse 的参数必须是合法 JSON 字符串;文件内容不合法会直接抛错;解析数组得到数组,不要误当对象。
把对象转成 JSON 字符串并写入文件
为什么需要反向操作?因为对象不能直接“原样”存进文件,需要先变成 JSON 字符串。怎么想?用 JSON.stringify 把对象/数组转成字符串,再用 fs.writeFile 写入。转写稿里还用 URL 解析出的对象做示例,说明任意普通对象都可以转。
怎么做?
js
const obj = {
  name: '小乐',
  password: 666666,
  email: '小乐@qq.com'
};

const jsonStr = JSON.stringify(obj);

const outPath = path.resolve(__dirname, 'day03.json');

fs.writeFile(outPath, jsonStr, err => {
  if (err) {
    console.log('文件写入失败', err.message);
    return;
  }
  console.log('文件写入成功');
});易错点:writeFile 第一个参数是路径,第二个是数据,第三个是回调;转写稿里也确认了这个顺序。写入的 JSON 字符串没有换行和缩进不是错误,因为它是给程序读的,不是给人读的。对象里如果有方法,JSON.stringify 不会把方法解析进去,所以数据对象应只放纯数据。
小结与调试提醒
本节核心就是两条线:读取时 readFile → utf8 字符串 → JSON.parse → 对象/数组;保存时 对象/数组 → JSON.stringify → 字符串 → writeFile。调试时先确认文件内容合法,再确认读出来的是不是字符串,最后确认 parse 后是不是对象或数组。JSON 是内置对象,不用导入;扩展名写 .json;路径用 __dirname 拼;出错先看 err.message。
先明确:本节讲什么
本节聚焦“模块化”。转写稿中没有继续展开 fs、url、querystring 的具体 API,而是回头讲 JS 模块化的规范演进、Node 支持哪两种写法、Node 模块如何分类,以及后续学习路线。核心结论是:Node 同时支持 CommonJS 和 ES6 模块规范;实际学习中两种都要会,但 Node 里 CommonJS 更常见,前端工程化里 ES6 模块更常见。
模块化为什么需要
为什么需要:代码一多,全塞进一个文件会难维护、难复用,也容易命名冲突。
怎么想:按职责拆文件,每个文件只负责一块能力,再通过“引入/导出”建立关系。
怎么做:在 Node 中,每个 .js 文件本身就是一个自定义模块;用 require 引入,用导出语法暴露能力。
易错点:不要为了模块化而拆得过碎;也不要以为浏览器天生就能直接跑 CommonJS。
四种规范与历史推导
为什么需要:JS 早期语言本身不支持模块化,社区只能先制定规范。
怎么想:转写稿里的推导是:先列出 CommonJS、AMD、CMD,再判断“现在还要关注谁”。CommonJS 最典型地被 Node 原生支持;AMD 需要 require.js 这类库;CMD 需要 sea.js 这类库;后来 ECMAScript 原生支持模块化,也就是 ES6 模块规范。
怎么做:今天重点掌握两种:CommonJS 和 ES6 模块。AMD/CMD 了解历史即可,不必作为主线。
易错点:require.js 是库名,不是 Node 里的 require 语法;AMD/CMD 是社区规范,不要和 ES6 原生模块混为一谈。
Node 为什么同时支持两种语法
为什么需要:Node 先支持 CommonJS,后来 ES6 又原生支持模块化,所以 Node 两套都能用。
怎么想:运行环境决定支持方式。Node 不是浏览器,它内置了模块体系;ES6 模块则是语言层面的规范。
怎么做:CommonJS 写法是:
js
const fs = require('fs');ES6 模块写法是:
js
import fs from 'fs';易错点:初学阶段不要把两种语法混在同一个文件里;先按教程选一种写顺,再对比差异。转写稿也强调:Node 里 CommonJS 用得多,是因为生态、教程、老代码都已习惯;但 ES6 模块也必须学,因为前端工程化大量使用。
Node 模块分类
为什么需要:知道模块来源,才能判断“要不要安装、路径怎么写、去哪查文档”。
怎么想:Node 模块分三类:内置模块、自定义模块、第三方模块。
怎么做:内置模块如 fs、path、url、querystring,直接 require;自定义模块就是自己写的每个 JS 文件;第三方模块由别人开发,通常用 npm 下载。
易错点:内置模块不需要 npm 安装;第三方模块不是内置模块;自定义模块引入时路径要写对,否则会报“找不到模块”。
学习路线与前端工程化
为什么需要:Node 要模块化,前端工程化也要模块化。
怎么想:Node 里 CommonJS 更常见;前端工程化里 ES6 模块更常见。转写稿的判断是:两种都讲、都学,通过对比记忆。
怎么做:先掌握 CommonJS 的引入导出,再学 ES6 的 import/export;后面做前端工程化时,构建工具会处理浏览器不直接支持的问题。
易错点:不要以为浏览器天生支持所有模块写法;也不要因为 AMD/CMD 现在少用,就否认它们在历史上的推动作用。转写稿的原话大意是:社区规范倒逼了语言规范进步,但今天主线只需关注 CommonJS 和 ES6 模块。
为什么需要模块规范
模块化的直接目的,是把代码按职责拆成一块一块,便于维护、阅读和复用。转写稿里说得很直白:分了模块之后,代码“非常好维护,一部分一部分的,条理也比较清晰”。但只拆文件还不够,文件之间如何引入、如何暴露内容,必须有统一约定,否则每个人写法不同,项目就会乱。这个“约定”就是模块规范。
怎么想:先区分“模块化”与“模块规范”。模块化是开发方式,模块规范是语法和加载规则。怎么做:学习一种规范时,重点看它如何引入模块、如何导出内容、运行环境是否原生支持。易错点:不要把“模块化”当成某个工具专有;也不要把某种规范等同于语言本身。
四种模块规范的历史位置
转写稿总结了几种常见规范:CommonJS、AMD、CMD,以及后来的 ECMAScript 模块规范。早期 CommonJS、AMD、CMD 更像是社区大佬制定的方案,JavaScript 语言本身并不直接支持,需要借助运行环境或外部库。比如 CommonJS 最典型的支持者就是 Node;AMD 常借助 RequireJS 这类库落地;CMD 也曾有 Sea.js 这类实现。它们在当时解决了模块化问题,但后来 ECMAScript 原生支持模块化,AMD、CMD 就基本退出主流。
怎么想:不要孤立背名字,要抓住“谁支持它”。怎么做:看到 CommonJS,先想到 Node 的 require;看到 ES6 模块,先想到 import。易错点:require 是 CommonJS 的引入语法,不是 RequireJS 这个库的名字;AMD/CMD 也不是 Node 内置规范。
CommonJS 在 Node 中的位置
转写稿强调:Node 本来就支持 CommonJS,所以可以直接用 require 引入模块。这也是为什么很多 Node 教程、老代码、生态项目里大量出现 CommonJS。CommonJS 不是“过时到不能用”,而是 Node 生态长期积累下来的写法,程序员已经习惯。与此同时,Node 后来也支持 ES6 模块规范,所以结论是:Node 中支持两种模块语法,一种是 CommonJS,一种是 ES6 模块。
怎么想:判断一个项目片段用什么规范,先看引入语句——出现 require 通常是 CommonJS,出现 import 通常是 ES6 模块。怎么做:在 Node 里学习 CommonJS,重点掌握 require 的引入思路;同时知道 ES6 模块用 import,两者区别首先是语法不同。易错点:不要因为“Node 支持 ES6 模块”就认为 CommonJS 没用了;转写稿明确说,Node 上 CommonJS 用得仍然比较多,因为历史习惯和生态沉淀。也不要看到 Node 就断定只能用 CommonJS,Node 是两种都支持。
CommonJS 与 ES6 模块的对比
转写稿把两者区别归结得很清楚:语法不一样。CommonJS 引入模块用 require;ES6 模块引入用 import。为什么还要学 ES6 模块?因为前端工程化开发大量使用 ES6 模块规范,后面用 Vue、React 等开发时,模块化写法绕不开。虽然本节聚焦 CommonJS,但必须知道它不是唯一答案。
怎么想:学习时不要只记“CommonJS 是 Node 的”,而要记“CommonJS 是规范,Node 是支持者;ES6 模块是语言原生规范,前端工程化常用”。怎么做:对比记忆——require 对应 CommonJS,import 对应 ES6;Node 两种都支持,前端浏览器不是天生具备模块化能力,需要外部工具或库支持。易错点:把“Node 支持”误写成“只有 Node 支持”;把“前端常用 ES6 模块”误写成“CommonJS 不能在前端用”。转写稿说前端也能用 CommonJS,但需要引入相应支持,不是浏览器天然直接支持。
Node 中的模块分类与学习路径
转写稿把 Node 模块分为三类:内置模块、自定义模块、第三方模块。内置模块是 Node 自带的,已经用过的 fs、path 就是;自定义模块是用户创建的每个 JS 文件,只要运行在 Node 上,就可以作为模块;第三方模块是别人开发、通过包管理工具 npm 下载使用的模块。接下来的学习分两部分:CommonJS 和 ES6 模块规范,分别看、对比记。
怎么想:先建立分类,再学语法,避免把“内置模块”和“模块规范”混为一谈。怎么做:内置模块直接引入使用;自定义模块由自己拆文件;第三方模块用 npm 获取。易错点:fs、path 是内置模块,不是 CommonJS 规范本身;CommonJS 是“怎么组织模块”的规范,内置模块是“Node 提供了什么”。把这两层分清,后面写自定义模块时就不会乱。
课堂画面
代码示例
1. 异常处理:try...catch 捕获系统错误与主动抛出的错误
js
// 03-异常处理/03-try-catch捕获异常.js

try {
  // getInfo();  // 系统报错:调用不存在的函数
  throw new Error('小乐 is not defined'); // 主动抛出错误
  console.log('try 内部:错误之后的语句不会执行');
} catch (err) {
  console.log('编号:', err.errno);
  console.log('信息:', err.message); // 小乐 is not defined
}

console.log(199); // try/catch 之后的语句照常执行要点解释与易错点:
throw new Error('...')是最规范的主动抛出方式,抛出的就是错误对象(Error的实例),err.message能取到错误信息。throw后面跟字符串、数字也能抛,但拿不到message、errno这些属性,不推荐。- 一旦
try内部出现错误(无论是系统报错还是主动throw),try中错误之后的语句立即停止执行,直接跳到catch。 catch捕获之后,系统不再报错、程序不再中断,catch后面的语句(console.log(199))照常执行——这就是try...catch的意义:把错误的影响范围缩到最小。- 易错点:不加
try...catch时,错误会直接中断整个程序;另外err.errno在自定义Error上通常是undefined,不要指望它一定有值。
2. JSON 数据处理:JSON.parse 与 JSON.stringify
js
// 04-json格式处理/data01.json
// { "name": "小乐", "age": 101, "address": "上海", "child": ["司马姥姥", "欧阳姥姥", "东方姥姥"] }

// 04-json格式处理/day01.js
const fs = require('fs');
const path = require('path');

// 读 JSON 文件:字符串 → 对象
fs.readFile(path.resolve(__dirname, 'data01.json'), 'utf-8', (err, data) => {
  if (err) return console.log('读取文件失败', err.message);
  console.log(data);            // 此时是字符串
  const obj = JSON.parse(data); // 解析成对象
  console.log(obj);             // 对象
  console.log(obj.child[1]);    // 欧阳姥姥
});

// 对象 → JSON 字符串 → 写入文件
const user = { name: '小乐', password: 666666, email: '小乐@qq.com' };
const str = JSON.stringify(user);
fs.writeFile(path.resolve(__dirname, 'data03.json'), str, (err) => {
  if (err) return console.log('文件写入失败', err.message);
  console.log('文件写入成功');
});要点解释与易错点:
fs.readFile不传'utf-8'拿到的是Buffer,传了才是字符串;而从文件读出来永远是字符串,不会是对象,必须JSON.parse才能取属性。JSON.parse解析失败会直接抛错,字符串格式必须是双引号、不能有单引号、不能有函数和表达式(1+2这种不行)。JSON.stringify只处理静态数据,对象里的方法会被丢掉,所以数据对象只写键值对。fs.writeFile会覆盖原文件内容,重复运行不会追加;JSON 字符串里没有换行和缩进,这是正常的——它是给程序读的,不是给人读的。- 两个方法的参数方向别搞反:
JSON.parse参数是字符串,JSON.stringify参数是对象。
3. CommonJS 模块规范:require 引入 + module.exports 导出
js
// 05-模块化/tools.js  —— 自定义模块(一个 js 文件就是一个模块)
const path = require('path'); // 引入内置模块

function getInfo() {
  return '小乐 is not defined';
}

module.exports = { getInfo }; // 导出,供别的文件使用

// 05-模块化/index.js  —— 使用模块
const fs = require('fs');            // 内置模块
const { getInfo } = require('./tools'); // 自定义模块,路径必须写 ./

console.log(getInfo());
console.log(typeof fs.readFile); // function要点解释与易错点:
- 在 Node 中,每一个
.js文件天生就是一个模块,不需要额外声明。 require就是 CommonJS 规范的引入语法;Node 内置支持,所以内置模块(fs、path)和自定义模块都用同一个require。- 引入自定义模块必须带相对路径前缀
./(或../),直接写require('tools')会被当成内置模块或第三方模块去找,报“找不到模块”。 - 导出的内容通过
module.exports挂出去,另一端require拿到的就是导出的那个东西,可以直接解构。 - 易错点:被
require的模块会立即执行一遍,模块内的顶层代码会被运行;同一模块多次require只会执行一次(有缓存)。
常见错误
现象:流式复制跑完了、文件也确实复制成功,但控制台迟迟不打印“复制成功”。 原因:把完成事件挂在了写入流上,事件名写成
close或时机不对,写入流结束时该事件并未按预期触发。 修法:完成信号挂在读取流的end上(读完了才算完),或写ws.on('finish');更省事的是直接用rs.pipe(ws),pipe会在结束时自动关闭写入流。现象:复制大文件时报
ERR_STREAM_PREMATURE_CLOSE,或出现“write after end”。 原因:在读取尚未结束时手动调用了rs.close()/ws.close(),把还在工作的流强行关掉了。 修法:不要手动关流,让end/finish自然触发;需要收尾逻辑就监听事件,而不是主动close。现象:
JSON.parse(data)抛Unexpected token或Unexpected token o in JSON at position 1。 原因:fs.readFile没传编码,拿到的是Buffer,参与字符串运算时被隐式转成了"[object Object]"之类的内容。 修法:读文件时第二个参数传'utf8',或先data.toString()再JSON.parse。现象:手写的
.json文件解析失败,或者解析出来少了字段。 原因:文件里用了单引号、写了注释、写了函数或1+2这类表达式——JSON 只接受双引号键名的纯静态数据。 修法:JSON 文件只写静态数据、键名和字符串一律双引号;需要可靠产出就用JSON.stringify生成,别手写。现象:
throw '出错了'之后,catch里拿err.message是undefined。 原因:抛的是字符串不是错误对象,catch捕获到什么就是什么。 修法:统一throw new Error('...'),保证catch里一定有message、stack可读。现象:
try块里出错后,try里错误位置后面的代码没执行,但catch之后的代码正常跑。 原因:try内部一旦抛错,整个try块立即终止,只是影响被限制在块内。 修法:把try缩到最小范围,只包住“确实可能出问题”的那一两行,别把整段业务逻辑塞进去。现象:
fs.readFile回调里抛的错,外层try/catch捕获不到。 原因:try块在回调执行前就已经结束了,异步回调抛错发生在另一个时刻。 修法:在回调函数内部再套一层try/catch,或者优先用回调的err参数判断。现象:
new URL(...)拿到的对象里取不到query,或者url.parse的结果里query是个字符串还得再转。 原因:两套 API 的属性名和形态不同,混着用。 修法:url.parse路线配querystring.parse处理query字符串;new URL路线直接用searchParams.get('name'),不要去找query。现象:
require('./utils')报Cannot find module,或module.exports赋值后exports.xxx失效。 原因:相对路径漏了./;以及module.exports重新赋值后与原exports引用脱钩。 修法:自定义模块一律写./开头;一个模块里只选一种导出风格,别混用。
练习
流式复制加健壮性:用
fs.createReadStream/createWriteStream复制一个大文件,要求:读流出错时打印错误并退出、复制完成后打印文件大小对比(源文件 vs 目标文件),并把手动write的版本改成pipe版本,观察代码量和事件处理的差别。异常边界实验:写一段代码,
try块内依次执行「正常语句 → 调用不存在的函数 → 后续语句」,catch里打印err.message,try/catch之后再打印一行。分别跑「不包try/catch」和「包try/catch」两次,记录哪些行执行了、哪些没执行,用自己的话写三行结论。JSON 往返:把一份含姓名、年龄、地址的对象数组用
JSON.stringify写入data.json,再用fs.readFile+JSON.parse读回来,遍历输出每个人的姓名。然后手动把文件里的双引号改成单引号,再跑一次,观察报错信息并记录JSON.parse的报错位置提示。URL 双写法对照:给定一条带端口、查询串和锚点的地址,分别用
url.parse和new URL解析,打印出协议、主机名、端口、路径、查询参数。要求两种方式都能取到name和age两个查询参数的值,比较写法差异。模块拆分:把练习 3 的读写逻辑拆成两个文件:
fileUtil.js导出readJSON(path)和writeJSON(path, obj)(内部封装fs+JSON.parse/stringify,出错时throw new Error),main.js用require('./fileUtil')调用它们,并用try/catch处理文件不存在的情况。
原视频对照
| # | 视频 | 时长 |
|---|---|---|
| 1 | 内置模块fs-流式复制 | 10:53 |
| 2 | url | 12:13 |
| 3 | 内置模块querystring | 07:33 |
| 4 | 异常处理的语法 | 15:26 |
| 5 | JSON格式的处理 | 16:08 |
| 6 | 模块化开发介绍 | 10:01 |
小结
- 大文件用流、小文件用
readFile/writeFile,判断标准是“能不能一次性塞进内存”,不是代码长短。 pipe优于手动on('data') + write——手动版本要自己管背压、错误和关闭,pipe一次到位。fs的方法记不完,但套路固定:路径在前、回调在后、回调第一个参数永远是err,掌握套路就能查文档用任何方法。- 错误对象是这个语言里唯一“连错误都是一等公民”的体现,
throw就抛Error实例,别抛字符串。 try/catch的价值不在“不报错”,而在把故障影响面锁死在最小范围,让后续代码继续跑。try/catch只保护同步执行路径,异步回调里的异常必须在回调内部处理——这是新手最容易翻车的地方。- JSON 是数据交换格式而非代码:只有静态数据、双引号、无注释无函数;对象 ↔ 字符串的往返是持久化和传输的基础。
- 模块化规范如今只需关心 CommonJS 和 ES Module 两套,Node 两套都支持;前端工程化基本倒向 ESM,Node 生态存量则以 CommonJS 为主。