主题
正则表达式与正则表达式概述(正则表达式 1/3)
本页对应 课堂视频,共 5 段视频,约 1 小时 38 分。
学习目标
- 能说明正则表达式是对字符串进行模式匹配的工具,并列举用户输入验证、数据提取、敏感词替换等典型应用场景。
- 能识别并正确书写正则原子,包括普通字符、需转义的特殊符号、字符类
[]、字符类简写\d/\D/\w/\W及通配符.,并解释“一个原子匹配一个字符”的规则。 - 能使用数量修饰符
{n}、{n,m}、{n,}、?、+、*控制原子连续出现次数,并说明贪婪匹配在exec()返回结果中的表现。 - 能使用位置修饰符
^和$将正则匹配限定为整个字符串,并编写可验证完整手机号格式的正则表达式。 - 能使用模式单元
()将多个原子组合为一个整体,并对其整体应用数量修饰符。 - 能综合运用原子、字符类、数量修饰符、位置修饰符和模式单元,编写并解释手机号、QQ号、邮箱等常见格式验证正则。
知识点
正则表达式到底解决什么问题
为什么需要:用户输入、爬虫抓取、敏感词替换,拿到的都是字符串,但程序往往只关心“符合某种格式的那部分”。怎么想:正则的唯一作用是模式匹配,落到前端最常用的就是验证输入格式,比如用户名、手机号、邮箱。怎么做:先明确规则,再写正则,最后用 test 或 exec 验证。易错点:正则可读性差,写完自己都看不懂;它针对的永远是字符串,不是数字或 DOM 本身。
js
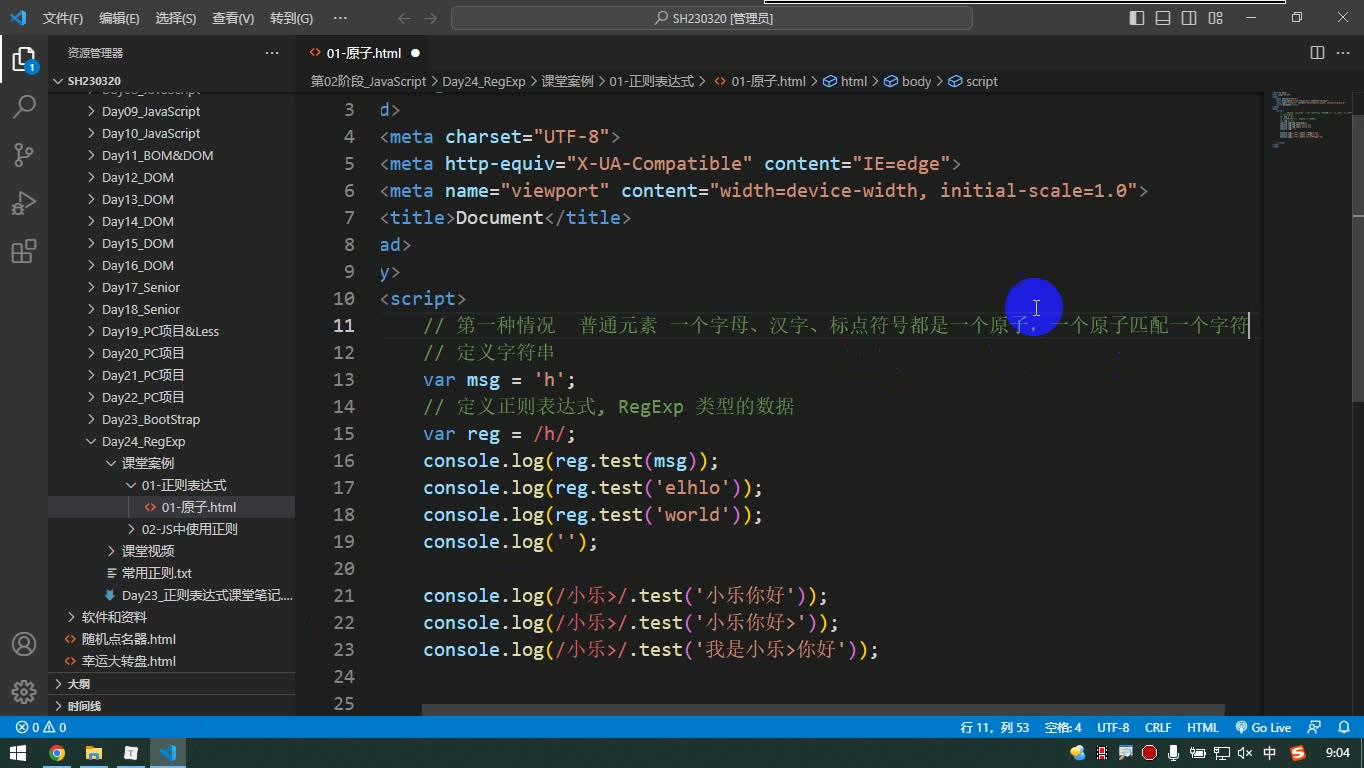
let reg = /H/;
console.log(reg.test("hello")); // true,只要包含 H/h? 这里只包含 H 才 true原子:一个原子匹配一个字符
为什么需要:正则由原子组成,先得知道“一个原子管一个字符”。怎么想:把字符串拆成字符看,H 原子只能匹配 H;多个原子连续写,就要求字符串中连续出现对应字符。怎么做:/H/.test("hello") 为 true,因为包含 H;/小乐>/.test("小乐你好") 为 false,因为没有连续的“小乐>”。易错点:test 默认是“包含”匹配,不是整串相等;/H/ 不要求字符串只有 H。
特殊符号与转义
为什么需要:斜杠、点、中括号等在正则里有特殊含义,想匹配符号本身必须转义。怎么想:先判断这个符号是不是正则语法的一部分;是,就在前面加反斜杠。怎么做:匹配斜杠写 /\//,匹配点写 /\./。易错点:直接写 // 会被当成注释或空正则;/./ 匹配任意字符,不是只匹配点。
js
console.log(/\//.test("/")); // true
console.log(/\./.test(".")); // true字符类:一个原子匹配一类字符
为什么需要:H 只能匹配 H,太死;我们希望一个原子能匹配“H 或 h 或小或乐或 1 或 4”。怎么想:中括号整体是一个原子,仍然只匹配一个字符;[^...] 表示排除。怎么做:/[Hh小乐14]/;范围写 [0-9]、[A-Za-z];简写 \d 是数字,\D 是非数字,\w 是数字字母下划线,\W 相反。易错点:\w 不含短横线,邮箱前面要写 [\w-];^ 只有在 [ 后才是排除。
js
console.log(/[Hh小乐14]/.test("乐")); // true
console.log(/[^Hh小乐14]/.test("乐")); // false
console.log(/\d/.test("7")); // true
console.log(/\W/.test("-")); // true数量修饰符:把重复写法定下来
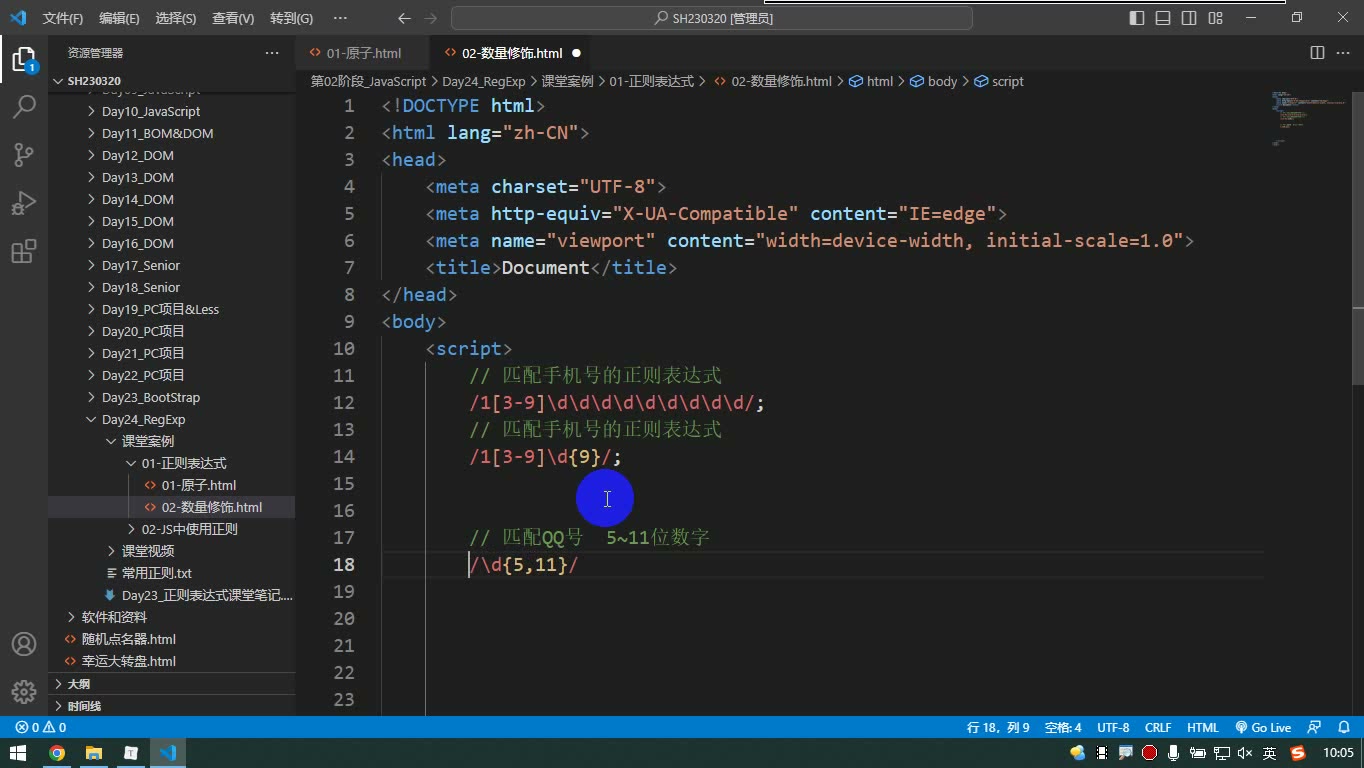
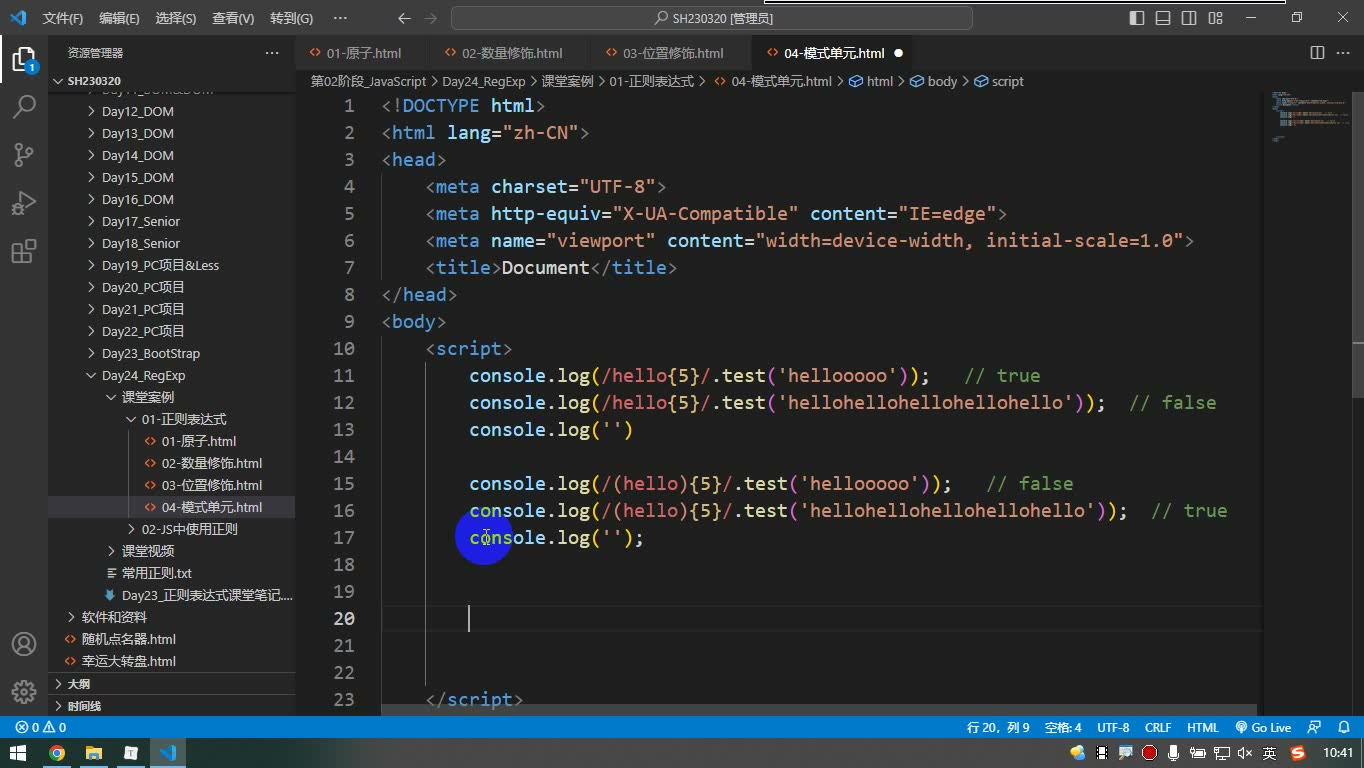
为什么需要:手机号后 9 位如果写 9 个 \d 太傻。怎么想:数量修饰符写在原子后面,只修饰紧邻的前一个原子。怎么做:{9} 固定 9 次,{5,11} 5 到 11 次,{12,} 至少 12 次;简写 ? 是 0 或 1 次,+ 是 1 次以上,* 是 0 次以上。易错点:/hello{5}/ 修饰的是 o,不是 5 个 hello;要修饰整体得用 (hello){5}。exec 会贪婪匹配,/\d{4,6}/.exec("1234567") 会尽量取 6 位。
js
console.log(/^1[3-9]\d{9}$/.test("13812345678")); // true
console.log(/\d{5,11}/.test("123456")); // true
console.log(/[A-Za-z]{12,}/.test("abcdefghijkl")); // true
console.log(/hello{5}/.test("hellooooo")); // true
console.log(/(hello){5}/.test("hellohellohellohellohello")); // true位置修饰符:让验证变成“整串匹配”
为什么需要:/1[3-9]\d{9}/ 验证手机号时,AB13712345678 也会 true,因为只要求包含。怎么想:前端验证输入格式,必须限制开头和结尾。怎么做:^ 表示字符串开始,$ 表示字符串结束;手机号写成 /^1[3-9]\d{9}$/。易错点:不加 ^$ 就是包含匹配;加上后,字符串中不能多也不能少,等于同时限制了数量。
js
console.log(/1[3-9]\d{9}/.test("AB13712345678")); // true
console.log(/^1[3-9]\d{9}$/.test("AB13712345678")); // false模式单元:把多个原子打包
为什么需要:数量修饰符默认只管前一个原子,想管“多个原子组成的整体”就得打包。怎么想:小括号把多个原子作为一个整体,再在括号后加数量。怎么做:/(hello){5}/;邮箱可写成 /^[\w-]+@\w+(\.\w+){1,2}$/。易错点:括号位置放错会改变含义;邮箱规则这里只是简化版,点必须写 \.,\w 不含短横线,所以前面用 [\w-]+。
js
console.log(/^[\w-]+@\w+(\.\w+){1,2}$/.test("[email protected]")); // true收束:前端要掌握到什么程度
为什么需要:正则细节极多,但前端日常主要是验证和提取。怎么想:先抓原子,再看数量修饰,再看位置修饰,最后看括号整体。怎么做:手机号、QQ号、邮箱这类规则先拆成“每个字符是什么、出现几次、是否整串”。易错点:不要死记复杂正则;先写小案例用 test 调,必要时用 exec 看匹配结果;调试时重点检查“包含还是整串”“修饰的是谁”“特殊符号有没有转义”。
先保留本节笔记
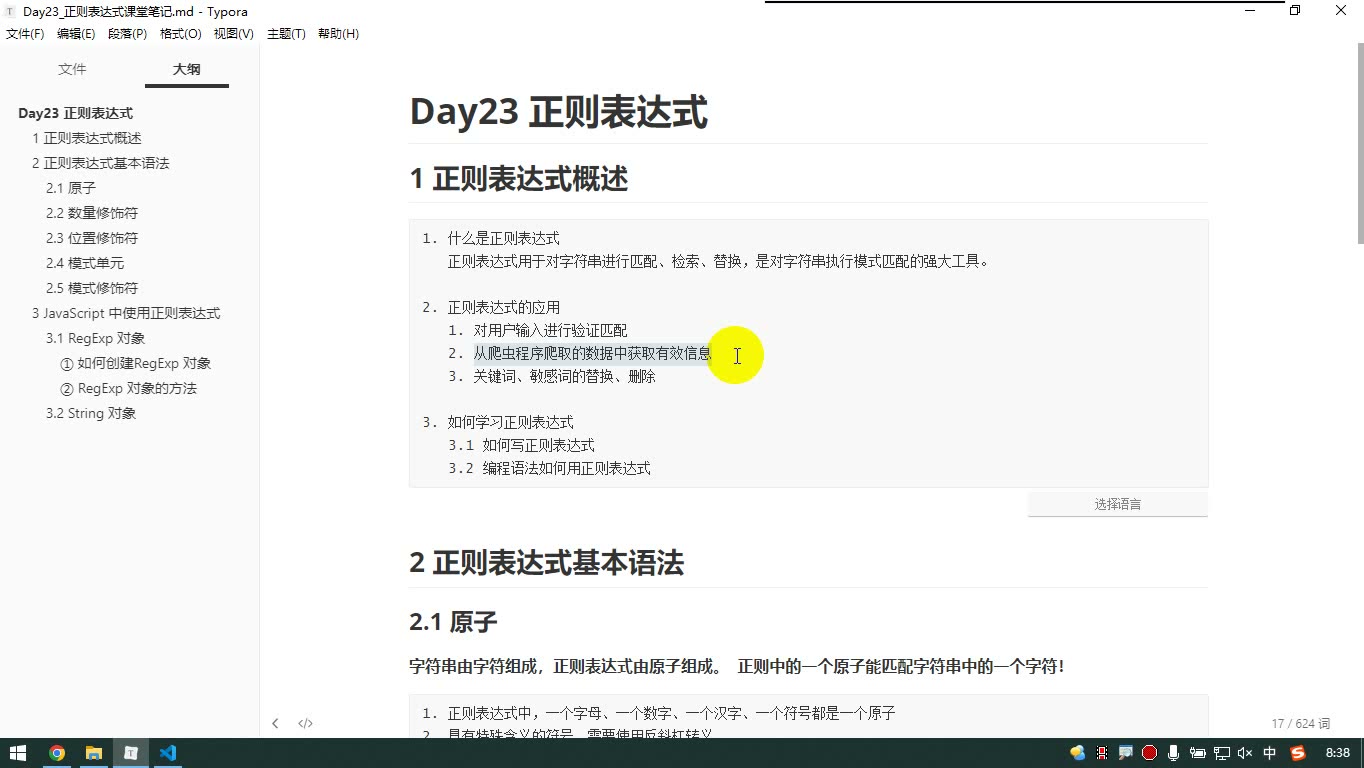
1. 什么是正则表达式
   正则表达式用于对字符串进行匹配、检索、替换,是对字符串执行模式匹配的强大工具。

2. 正则表达式的应用
   1. 对用户输入进行验证匹配
   2. 从爬虫程序爬取的数据中获取有效信息
   3. 关键词、敏感词的替换、删除

3. 如何学习正则表达式
   3.1 如何写正则表达式
3.2 编程语法如何用正则表达式什么是正则表达式
为什么需要: 程序里大量数据都是字符串:用户输入的用户名、手机号、邮箱,爬虫抓下来的网页源码,文章里的敏感词,都是字符串。只靠 maxlength 或简单判断,很难规定“只能包含什么、必须是什么格式”。正则表达式就是用来描述字符串格式规则的工具。
怎么想: 不要把它想成“找某个固定字符”,而要想成“描述一类字符的模式”。转写稿里反复强调四个字:模式匹配。它针对的永远是字符串,不是数字本身;哪怕输入框里写的是手机号,程序拿到手里也是字符串。
怎么做: 用正则对字符串做匹配、检索、替换。比如验证手机号格式、从网页源码中提取商品名和价格、把敏感词替换掉。在 JavaScript 中,正则是 RegExp 类型的数据,可以用构造函数或直接量定义,后面会用 test() 做验证、用 exec() 看匹配结果。转写稿中的调试方式是:先写死一个字符串和一个正则,再在控制台看 true/false,例如 /H/.test("hello") 会得到 true,因为字符串中包含能匹配原子 H 的字符。
易错点: 正则可读性差,写完自己都可能看不懂,所以不要一上来追求复杂表达式;要记住它处理的是字符串;还要区分“包含匹配”和“完全匹配”。转写稿里手机号例子中,AB137... 也能通过,是因为当时只判断“包含”符合条件的连续字符,前端验证通常还要加首尾位置约束。
正则表达式的应用
为什么需要: 第一类是用户输入验证。转写稿举了百度注册的例子:用户名仅支持中英文、数字和下划线,不能是纯数字,还有长度要求;手机号、邮箱、QQ号、邮编、身份证号也都有格式。第二类是爬虫提取信息:网页源码是一大段 HTML 字符串,里面大部分是标签和无效信息,真正要的是商品名称、图片、价格。第三类是敏感词、关键词的替换和删除。
怎么想: 先明确“规则”再写表达式。用户名校验要列出允许的字符和长度;手机号要按位数和开头数字想;爬虫不要直接处理整个网页,而是找商品信息附近的标签、类名等特征,把需要的内容从字符串中提取出来;敏感词不要只死记具体词,要找共同特征,方便统一替换或删除。
怎么做: 用户输入用正则做匹配验证;爬虫拿到 HTML 字符串后,用正则按特征提取有效信息;文章内容用正则检索并替换敏感词。转写稿也提醒:爬虫爬的应是公开数据,比如商品价格、公开工商信息;不公开的数据不是爬虫能做的,可能涉及破坏计算机系统,不能乱来。
易错点: 不要以为输入框只能靠 maxlength 限制长度,它限制不了“只能包含谁”;爬虫不是黑客技术,不能把“爬公开数据”和“入侵系统”混为一谈;敏感词替换不要只写死几个词,要观察共同特征;验证规则要先定清楚,否则正则写得再复杂也不一定符合业务。
如何学习正则表达式
为什么需要: 正则表达式独立于编程语言,JavaScript 能用,Python、Java、PHP 也能用,表达式本身写法基本一致;但不同语言“怎么用正则”有差异。有的语言要求把正则写进字符串里,JavaScript 中正则是一种单独的数据类型。所以学习要分两步:先学表达式怎么写,再学所用语言怎么调用。
怎么想: 先把正则拆成几块:原子、数量修饰符、位置修饰符、模式单元等;再学 JavaScript 里的 RegExp、直接量、test()、exec() 等方法。转写稿建议先做小案例:一个输入框填正则,一个输入框填字符串,用程序验证是否匹配;也可以先写死字符串和正则,在控制台观察结果。
怎么做: 从简单原子开始练:一个字母、一个数字、一个汉字、一个符号都是原子,一个原子匹配一个字符;连续写几个原子,字符串中也要有连续匹配的字符。再学数量修饰符,比如固定次数、区间次数、至少次数;再学 ^ 和 $ 约束开头结尾;最后学小括号把多个原子当成整体。调试时用 test() 看布尔值,用 exec() 看实际匹配到的内容,并注意贪婪匹配会尽可能多匹配。
易错点: 数量修饰符只修饰紧邻的前一个原子,想修饰多个原子要用小括号;特殊符号想匹配本身要转义;不要混淆字符串引号和正则直接量的斜杠;不要死记复杂正则,前端开发先掌握常用验证和提取;写完要用多个反例测试,不能只看一个能通过的字符串。
正则表达式的基本定位
为什么需要:用户输入的用户名、手机号、邮箱、QQ号都有格式要求,单靠 maxlength 只能限制长度,不能限制“只能包含谁、不能包含谁”。正则表达式就是做字符串模式匹配的工具,常见于输入验证、爬虫数据提取、敏感词替换。
怎么想:先记住它针对的永远是字符串;写法独立于语言,但不同语言调用方式不同。JavaScript 中正则是 RegExp 类型,可用字面量 /.../ 或构造函数 new RegExp()。
怎么做:先学“表达式怎么写”,再学 JS 中 test、exec 怎么用。
易错点:不要把正则写成普通字符串;字面量两边的斜杠不是正则内容,斜杠里面才是。
原子:正则的最小匹配单位
为什么需要:正则由一个个“原子”组成,原子类似字符串中的字符,是匹配的最小单位。
怎么想:一个原子匹配一个字符;正则里连续写多个原子,字符串中也要能找到连续匹配的字符。
怎么做:
js
const reg = /h/;
console.log(reg.test("hello")); // true
console.log(reg.test("word")); // falsetest 只判断字符串中是否“包含”能匹配的内容,不要求整串完全一样。
易错点:/小乐>/ 要求三个原子连续匹配;字符串 "小乐你好" 没有 >,所以失败。不是“只要匹配一个原子就行”,而是每个原子都要在字符串中找到对应字符。
特殊符号与转义
为什么需要:斜杠、点号、中括号等在正则中有特殊含义,想匹配符号本身必须处理。
怎么想:有特殊含义的符号,前面加反斜杠 ` 转义,让它变成普通原子。 **怎么做**:匹配斜杠写 ///;匹配点号写 /./。 **易错点**:/./中的. 表示任意字符,不是“点本身”;/./` 才匹配点。转义符不要漏写。
字符类:一个原子匹配一类字符
为什么需要:如果一个原子只能写死 h、小,表达能力太弱;字符类让一个原子匹配“多个候选字符中的一个”。
怎么想:中括号 [...] 表示候选集合;[^...] 表示排除这些字符;\d、\D、\w、\W 是简写。
怎么做:
js
/[小乐Hh14]/.test("乐");   // true
/[^小乐Hh14]/.test("乐");  // false
/\d/.test("7");            // true
/\w/.test("_"); // true[a-zA-Z0-9_] 可匹配大小写字母、数字、下划线;[\w-] 是在 \w 基础上再加短横线。
易错点:字符类再复杂,一个中括号仍然只匹配一个字符;^ 在字符类内表示取反,在正则开头表示字符串开始,含义不同。
数量修饰符:让原子重复
为什么需要:手机号后 9 位都是数字,不能真写 9 个 \d;量词可指定重复次数。
怎么想:量词写在原子后面,只修饰紧邻的前一个原子。{n} 固定 n 次,{n,m} n 到 m 次,{n,} 至少 n 次;? 是 0 或 1 次,+ 是 1 次以上,* 是 0 次以上。
怎么做:
js
/1[3-9]\d{9}/.test("13812345678"); // true
/^\d{5,11}$/.test("123456"); // true调试贪婪匹配:
js
/\d{4,6}/.exec("123456789"); // 返回 "123456"exec 会尽可能多匹配,这叫贪婪匹配。
易错点:/ab{5}/ 修饰的是 b,不是 ab;要修饰整体写成 /(ab){5}/。大括号 {} 是量词,中括号 [] 是字符类,不要混。
位置修饰符:限制整串匹配
为什么需要:test 默认只判断“包含”。例如 /1[3-9]\d{9}/.test("AB13712345678") 也可能为 true,但这不是合法手机号。
怎么想:^ 表示字符串开始,$ 表示字符串结束;前后都加,才要求整串完全匹配。
怎么做:
js
const reg = /^1[3-9]\d{9}$/;
console.log(reg.test("AB13712345678")); // false
console.log(reg.test("13712345678")); // true易错点:前端做输入验证时通常要加 ^...$;不加就只能算“包含某段格式”,不能算“整串符合格式”。^ 在字符类内是取反,别和开头锚点混淆。
模式单元:把多个原子当一个整体
为什么需要:量词只修饰前一个原子,/hello{5}/ 只让 o 重复 5 次,不能让 hello 重复 5 次。
怎么想:用小括号把多个原子包成一个整体,再对这个整体加量词。
怎么做:
js
/hello{5}/.test("hellooooo"); // true
/(hello){5}/.test("hellohellohellohellohello"); // true邮箱中常用整体:
js
const email = /^[\w-]+@\w+(\.\w+){1,2}$/;(\.\w+) 把“点 + 域名”作为一个整体,{1,2} 允许类似 .com 或 .com.cn。
易错点:小括号会改变量词作用范围;邮箱验证别忘 ^ 和 $,否则仍可能只是包含匹配。
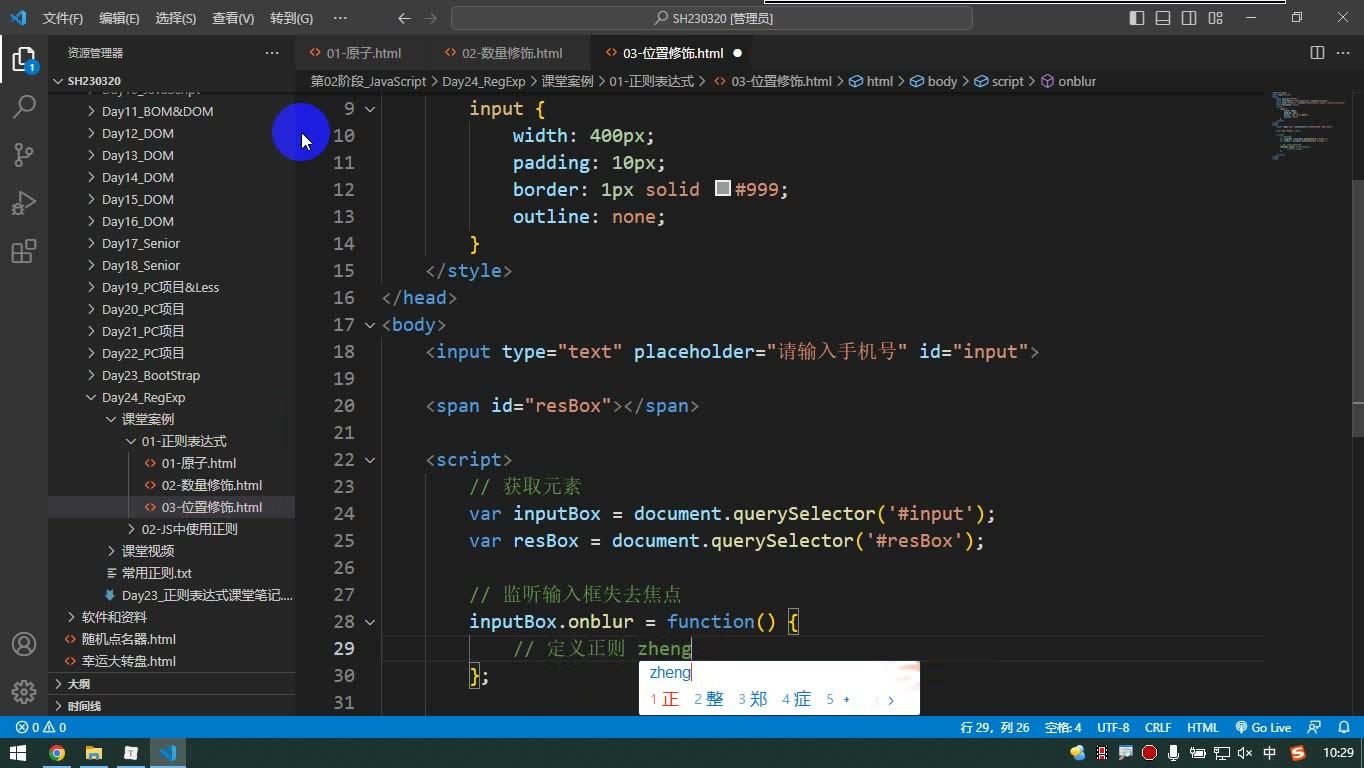
综合案例:手机号输入验证
为什么需要:把语法落到真实输入框验证中。
怎么想:失焦时取输入值,用带首尾锚点的正则判断,再更新提示文本和颜色。
怎么做:
js
input.onblur = function () {
  const reg = /^1[3-9]\d{9}$/;
  if (reg.test(input.value)) {
    span.innerHTML = "手机号可用";
    span.style.color = "green";
  } else {
    span.innerHTML = "请输入正确的手机号";
    span.style.color = "#f00";
  }
};易错点:input.value 拿到的是字符串;test 返回布尔值;若不加 ^$,AB137... 这种内容也可能被误判为通过。
课堂画面
代码示例
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>原子与字符类</title>
</head>
<body>
<script>
  // 普通原子:一个原子匹配一个字符
  const reg1 = /H/;
  console.log(reg1.test('H'));       // true
  console.log(reg1.test('Hello'));   // true
  console.log(reg1.test('word'));    // false

  // 连续原子:原子连续出现,匹配字符也要连续出现
  const reg2 = /小乐>/;
  console.log(reg2.test('小乐>'));   // true
  console.log(reg2.test('小乐'));    // false

  // 特殊符号转义:匹配斜杠本身
  const reg3 = /\//;
  console.log(reg3.test('a/b'));     // true

  // 字符类:一个中括号整体是一个原子,但字符种类可以是多个
  const reg4 = /[小乐H14]/;
  console.log(reg4.test('小'));      // true
  console.log(reg4.test('乐'));      // true
  console.log(reg4.test('4'));       // true

  // 字符类取反
  const reg5 = /[^小乐H14]/;
  console.log(reg5.test('小'));      // false
  console.log(reg5.test('A'));       // true

  // 范围与简写
  const reg6 = /[a-zA-Z0-9_]/;
  console.log(reg6.test('A'));       // true
  console.log(reg6.test('_'));       // true

  const reg7 = /\d/;
  console.log(reg7.test('7'));       // true
  console.log(reg7.test('a'));       // false

  const reg8 = /\D/;
  console.log(reg8.test('a'));       // true
  console.log(reg8.test('7'));       // false

  const reg9 = /\w/;
  console.log(reg9.test('_'));       // true
  console.log(reg9.test('-'));       // false

  const reg10 = /\W/;
  console.log(reg10.test('-'));      // true
  console.log(reg10.test('_'));      // false

  // 点号:匹配任意字符;只想匹配点本身需要转义
  const reg11 = /./;
  console.log(reg11.test('点'));     // true

  const reg12 = /\./;
  console.log(reg12.test('.'));      // true
  console.log(reg12.test('a'));      // false
</script>
</body>
</html>要点解释:
- 一个原子匹配一个字符;
test()返回布尔值,字符串中只要包含能匹配的部分即可。 - 连续写多个原子时,字符串中也要有连续出现的对应字符,例如
/小乐>/不能匹配小乐。 - 斜杠、点号等在正则中有特殊含义,匹配它们本身需要转义,如
/\//、/\./。 [小乐H14]整体是一个原子;[^...]表示取反。\d数字、\D非数字、\w数字字母下划线、\W非数字字母下划线。
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>手机号验证</title>
  <style>
    input {
      width: 400px;
      padding: 10px;
      border: 1px solid #999;
      outline: none;
    }
    span {
      margin-left: 10px;
    }
  </style>
</head>
<body>
<input id="input" type="text" placeholder="请输入手机号">
<span id="result"></span>

<script>
  const input = document.querySelector('#input');
  const result = document.querySelector('#result');

  input.addEventListener('blur', function () {
    const reg = /^1[3-9]\d{9}$/;

    if (reg.test(this.value)) {
      result.innerHTML = '手机号可用';
      result.style.color = '#0a0';
    } else {
      result.innerHTML = '请输入正确的手机号';
      result.style.color = '#f00';
    }
  });
</script>
</body>
</html>要点解释:
^表示字符串开始,$表示字符串结束;验证场景通常要同时加上,避免变成“包含即可”。[3-9]是字符类,表示第二位只能是 3 到 9。\d{9}中{9}是数量修饰符,只修饰紧邻在前面的\d。- 使用
blur失焦事件做验证,this.value获取输入框内容。 - 易错点:不加
^...$时,AB137xxxxxxxx这类字符串也可能被判断通过。
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>模式单元与邮箱正则</title>
</head>
<body>
<script>
  // hello{5}:数量修饰符只修饰紧邻的 o
  const reg1 = /hello{5}/;
  console.log(reg1.test('hellooooo'));                     // true
  console.log(reg1.test('hellohellohellohellohello'));     // false

  // (hello){5}:小括号把多个原子作为一个整体
  const reg2 = /(hello){5}/;
  console.log(reg2.test('hellohellohellohellohello'));     // true
  console.log(reg2.test('hellooooo'));                     // false

  // 邮箱正则:^[\w-]+@\w+(\.\w+){1,2}$
  const emailReg = /^[\w-]+@\w+(\.\w+){1,2}$/;
  console.log(emailReg.test('[email protected]'));           // true
  console.log(emailReg.test('[email protected]'));        // true
  console.log(emailReg.test('abc@163'));                   // false
  console.log(emailReg.test('[email protected]'));        // false
</script>
</body>
</html>要点解释:
hello{5}中的{5}只修饰前面的o,不是修饰整个hello。(hello){5}使用模式单元小括号,把hello作为一个整体再修饰数量。- 邮箱正则中
[\w-]+表示数字、字母、下划线或短横线出现一次或多次。 (\.\w+){1,2}中\.是转义点号;如果写成.会匹配任意字符,容易误匹配。^和$限制整个字符串,避免只匹配邮箱片段。
常见错误
现象:
/1[3-9]\d{9}/.test("abc13812345678xyz")返回true,用户随手输一串带手机号的乱码也提示"格式正确"。 原因:test()判断的是"字符串中包含能匹配的片段",不是"整个字符串就是它";没有位置约束,前后多出什么都不影响结果。 修法:凡是做输入验证,一律补上^和$(/^1[3-9]\d{9}$/)。判断标准很简单——问自己"这个字符串能不能多一个字符还通过?"能通过就是漏了边界。现象:想匹配 5 个连续的
hello,写成/hello{5}/,结果"hello"能过、"hellohellohellohellohello"反而过不了。 原因:数量修饰符只作用于紧邻它前面的那一个原子,{5}修饰的是o,不是整个hello。 修法:需要整体计数时用模式单元把多个原子括起来:/(hello){5}/。判断口诀——数量修饰符前面"贴着"的是谁,就只管谁。现象:验证"a 点 b"这种带点号的输入,写
/a.b/,结果"axb"、"a b"、"a1b"全被放过。 原因:.在正则里是元字符(匹配任意字符),不是普通标点;同理/、(、)、[、]、?、+、*、^、$、{、}直接写都会改变语义或让正则解析失败。 修法:要匹配元字符本身就加反斜杠转义:/a\.b/、/\//。经验做法——写完一条正则,逐个符号问"它在正则里有特殊含义吗",有就转义。现象:用构造函数拼正则:
new RegExp("\d{6}"),结果匹配不到纯数字,反而把"ddd"之类匹配上了。 原因:正则写在字符串里时要先过字符串的转义,"\d"在字符串阶段就变成了"d",传到正则引擎时` 已经没了。 **修法**:字符串里的反斜杠要双写:new RegExp("\d{6}");能用直接量/^\d{6}$/就别用构造函数,只有模式需要动态拼接时才用RegExp`。现象:
/^\w+$/.test("张三-abc")为false,或者邮箱正则里\w死活匹配不到中文、短横线,以为\w是万能的。 原因:\w只等价于[A-Za-z0-9_],不含中文、不含短横线、不含点。字符类简写是"够用"不是"全能"。 修法:需要额外字符时在方括号里追加:[\w-]、[\w.-];需要中文就显式列出范围或单独判断,别指望\w兜底。现象:
\d{4,6}去取字符串里的数字,"123456789"中exec拿到的是"123456",多要了两位;或者换成{4,}直接把整串数字吞掉。 原因:数量修饰符默认是贪婪的,在满足条件的前提下尽可能多取。 修法:明确要"最少"就在后面加?变惰性(\d{4,6}?),或者用^/$/\b之类的边界把范围框死。调试时用exec看真实结果,不要只看test的true。
练习
纯数字校验:写一个正则,要求用户输入的内容只能是 5–11 位数字(QQ 号规则),并说明为什么
/^\d{5,11}$/和/\d{5,11}/在真实表单里效果不同。手机号强化版:在
/^1[3-9]\d{9}$/基础上,改造为"允许用户在前后输入空格,但中间必须是合法手机号",写出正则并说明为什么不能简单地把^$去掉。邮箱拆解:给出
/^[\w-]+@\w+(\.\w+){1,2}$/,逐段说明每一部分在匹配什么;然后指出这条正则不能拦住哪一类明显非法的输入(至少举 2 例)。数量修饰符辨析:分别写出"至少 12 位大小写字母"和"至少 12 位、由字母数字下划线组成"的正则,并说明两者在原子选择上的差别。
改错题:下面三条正则各有问题,指出问题并改正:
/hello{5}/(意图:5 个 hello)/a.b/(意图:匹配字面的a.b)new RegExp("\w+@\w+")(意图:匹配邮箱主体)
参考要点:1) {5,11} 是原子数量区间,不是 {5-11};test 是包含匹配。2) 用 /^\s*1[3-9]\d{9}\s*$/,直接去边界会让中间夹带任意字符也通过。3) [\w-]+ 是 @ 前的用户名、\w+ 是域名主体、(\.\w+){1,2} 是 1–2 段后缀;拦不住 [email protected](空段)、[email protected] 这类过短后缀,也拦不住 [email protected] 这种以短横线开头的域名。4) 前者只能用 [A-Za-z]{12,},后者可用 [\w]{12,} 或 \w{12,}——区别在原子能覆盖的字符范围。5) /(hello){5}/、/a\.b/、new RegExp("\\w+@\\w+")。
原视频对照
| # | 视频 | 时长 |
|---|---|---|
| 1 | 正则表达式的基本介绍 | 16:06 |
| 2 | 原子 | 43:00 |
| 3 | 数量修饰符 | 20:38 |
| 4 | 位置修饰符 | 08:48 |
| 5 | 模式单元 | 09:49 |
小结
- 正则的最小单位是"原子",一个原子永远只匹配一个字符。读一条正则的正确姿势是:先数原子,再看修饰符,最后看边界——顺序错了就会读成"一堆乱码"。
- 复杂正则不是背出来的,是拆出来的。手机号、QQ 号、邮箱本质都是"字符范围 + 数量 + 边界"三段式,把需求翻译成"哪些字符、几个、从哪到哪",正则自然就出来了。
- 验证场景必须成对使用
^和$。只要目标是"校验用户输入",漏掉任何一个都等于把校验降级成"包含检查",这类 bug 在表单里最难被自己发现。 test只回答"有没有",exec才回答"是什么"。写正则时的第一调试动作应该是用exec打印实际匹配到的片段,而不是盯着true/false猜。- 元字符有两副面孔:当语法用时改变语义,当字符用时必须转义。养成"写完逐符号过一遍"的习惯,比事后 debug 便宜得多。
- 数量修饰符只认紧邻的前一个原子,这是初学者最高频的误解来源;需要整体计数就上模式单元
(),两条规则记牢,绝大多数"数量不对"的问题都能自解。 - 前端要掌握的是"够用"而非"精通":原子、字符类、数量修饰符、位置修饰符、模式单元这五件套覆盖了日常 90% 的场景;预查、反向引用等属于按需查阅,不必在入门阶段死磕。